
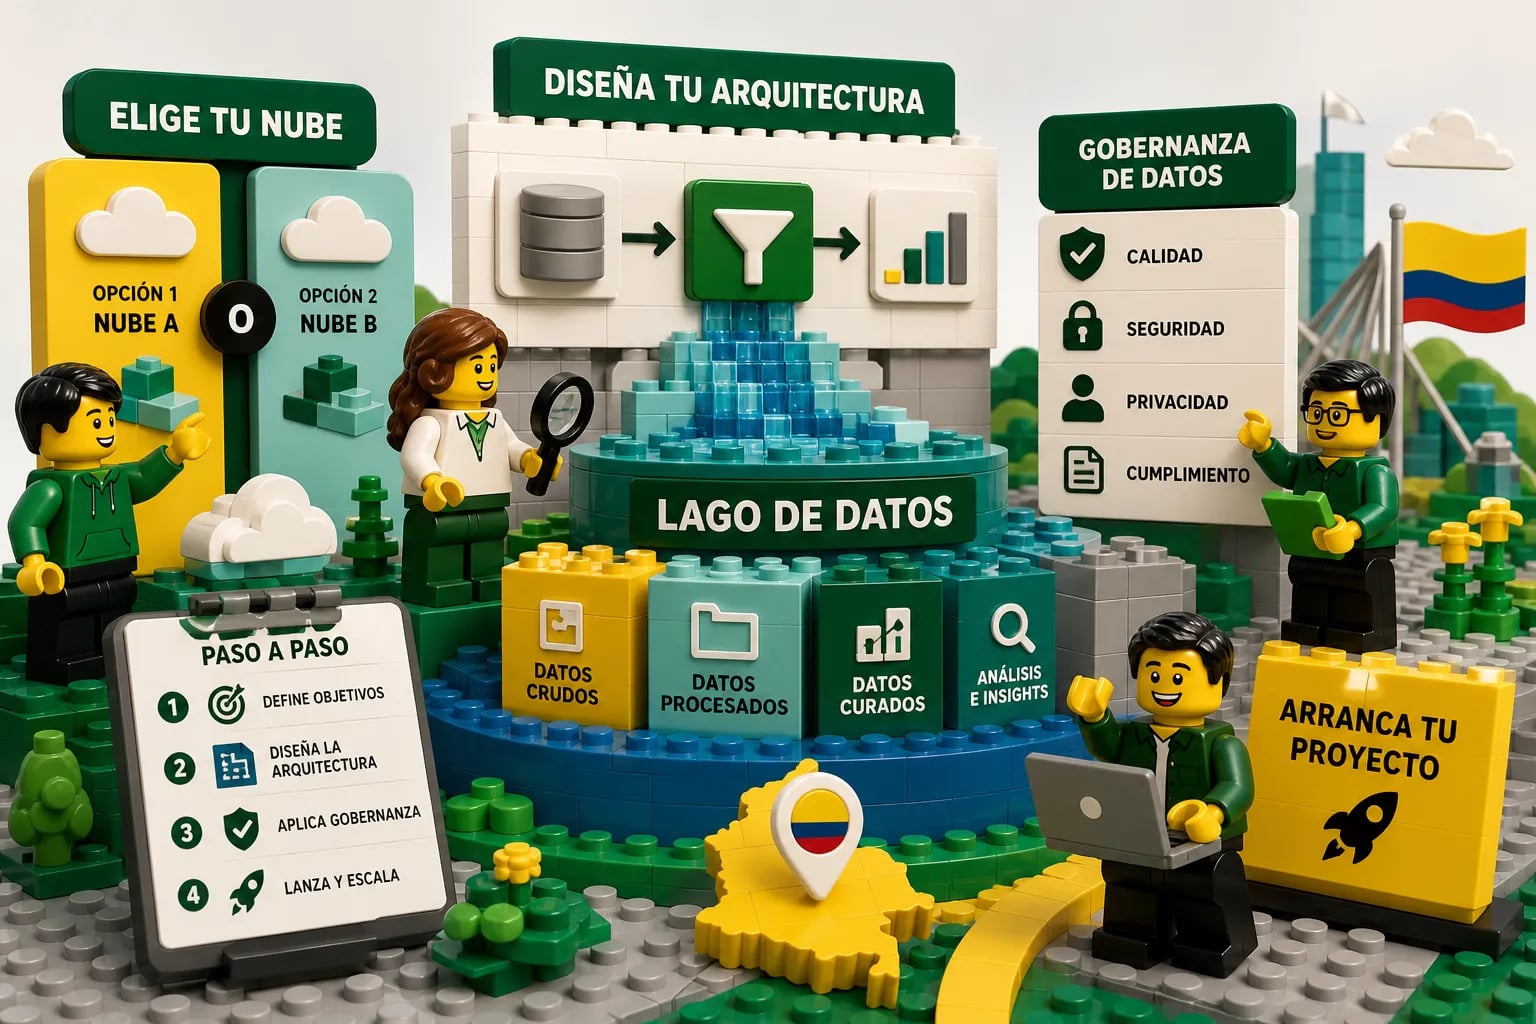

Las empresas colombianas acumulan datos de ERP, sensores, plataformas de comercio y fuentes externas que ningún almacén de datos tradicional puede absorber sin convertirse en un cuello de botella. Un lago de datos en la nube resuelve ese problema, pero solo cuando la implementación sigue un orden deliberado desde el primer día. En este artículo explicamos cómo implementar un lago de datos en un entorno de nube para organizaciones en Colombia: desde la elección de plataforma hasta la gobernanza, con un plan concreto para los primeros 90 días.
En EPAD Group SAS nuestro equipo ha trabajado en proyectos de arquitectura de lago de datos sobre Azure y AWS para organizaciones colombianas en sectores como manufactura, comercio minorista y servicios financieros. En ese proceso hemos visto los mismos puntos de quiebre repetirse una y otra vez. Este artículo recoge esas lecciones en pasos concretos.
Al terminar, tendrá claras las cuatro decisiones que realmente importan: plataforma, arquitectura, ingesta y gobernanza. Y sabrá exactamente cómo arrancar.
Elegir entre Azure y AWS: la decisión depende de su ecosistema actual
No existe una respuesta universal entre Azure Data Lake Storage Gen2 y Amazon S3 como base del lago. Si su organización usa Power BI, Microsoft 365 o tiene acuerdos de licenciamiento vigentes con Microsoft, Azure suele integrarse mejor. El ecosistema asociado, con Azure Data Factory para orquestación y Microsoft Purview para gobierno de metadatos y linaje, reduce la fricción técnica. Si trabaja con herramientas más abiertas o ya tiene cargas en AWS, el ecosistema de Glue, Lake Formation y Athena ofrece madurez equivalente con menos dependencias de licencia.
Para el contexto colombiano, dos variables adicionales pesan en la decisión: el cumplimiento de la Ley 1581 de 2012 sobre protección de datos personales y el costo total de operación. Ambas nubes ofrecen opciones de disponibilidad regional cercana y soporte en español, aunque la cobertura varía según el plan contratado; lo que también varía es la tarifa por operaciones y egreso de datos, que puede representar una diferencia estimada del 15 al 20% según el patrón de acceso. Calcule ese número con su perfil real antes de decidir.
Cómo implementar un lago de datos en la nube: arquitectura en capas
Una implementación sólida organiza el almacenamiento en tres zonas con propósitos distintos. La zona cruda recibe los datos tal como llegan de las fuentes y nunca se modifica. La zona intermedia contiene datos limpios, normalizados y con esquema definido. En la zona de consumo, los datos ya están enriquecidos y disponibles para consultas de inteligencia de negocios o modelos de aprendizaje automático. Saltarse alguna de estas capas genera deuda técnica que cuesta mucho más limpiar después que haberla diseñado desde el inicio.
Formatos de almacenamiento: Parquet, Delta Lake e Iceberg
Para el almacenamiento, Parquet es la base para lecturas analíticas por su compresión eficiente y poda de columnas. Delta Lake es preferible cuando hay actualizaciones frecuentes o canalizaciones con captura de cambios, aunque requiere compactación periódica para evitar la acumulación de archivos pequeños. Iceberg encaja mejor cuando se necesita independencia de motor o se trabaja con tablas muy grandes con evolución de particiones. Como regla práctica, apunte a archivos entre 128 MB y 1 GB, y particione por columnas de alta selectividad como fecha, región o categoría.
Ingesta de datos: procesamiento por lotes primero, flujo en tiempo real solo cuando el negocio lo justifica
En la mayoría de los casos de uso dentro de empresas colombianas medianas, el procesamiento en tiempo real no es necesario desde el primer día. Las fuentes empresariales como ERP, CRM y bases relacionales funcionan bien con ingesta por lotes usando AWS Glue, Azure Data Factory o herramientas como Airbyte con carga incremental automatizada.
El procesamiento en tiempo real tiene sentido cuando el caso de negocio lo exige: eventos de IoT, transacciones en vivo o registros de aplicación. Para esos escenarios, Kinesis Data Firehose en AWS y Event Hubs en Azure permiten escribir directamente hacia el almacenamiento del lago en formatos como Parquet. Apache Kafka, con conectores de salida, es la opción más portable cuando se quiere independencia del proveedor de nube.
Registre cada fuente en el catálogo desde el primer día: ubicación, esquema, frecuencia y propietario del dato. Sin ese registro, el lago empieza a crecer sin orden y se convierte en un problema difícil de revertir.
Gobernanza, catálogo y seguridad: no se agregan al final
Esta es la sección que la mayoría de los equipos pospone, y es el error más costoso que cometen en toda la implementación.
El cifrado en reposo y en tránsito es un requisito base, no un complemento. El control de acceso debe operar por roles, no por usuarios individuales, con revisiones periódicas de permisos y alertas ante accesos anómalos. AWS Lake Formation permite aplicar políticas granulares de acceso a nivel de fila y columna dentro de su ecosistema. Microsoft Purview, por su parte, está orientado al descubrimiento, la clasificación y el linaje de datos; la aplicación efectiva de restricciones a nivel de fila o columna depende del motor de consulta utilizado, Synapse, Databricks u otros, y puede requerir configuraciones adicionales. Ambas herramientas son relevantes para cumplir con la Ley 1581 cuando el lago contiene información personal o financiera.
El catálogo de metadatos: la diferencia entre un lago y un pantano
El catálogo de metadatos es lo que separa un lago funcional de un pantano. Sin catálogo, nadie sabe qué datos existen, de dónde vienen ni en qué estado están. AWS Glue Data Catalog y Microsoft Purview permiten registrar activos, documentar linaje y rastrear cómo se transforma cada dato a lo largo del proceso. Ese linaje no es un lujo: es lo que hace posible una auditoría real y el cumplimiento normativo. Los registros de acceso y cambios deben ser inmutables desde el inicio.
Los primeros 90 días: un plan de arranque concreto
La experiencia en proyectos con organizaciones colombianas muestra que un primer lago funcional puede estar operativo en cuatro a ocho semanas con dos o tres fuentes y un caso de uso de reporte. Un alcance más amplio con gobernanza completa toma entre tres y seis meses.
- Días 1 a 30: definir tres casos de uso prioritarios, inventariar fuentes de datos, elegir plataforma y aprovisionar el entorno base con zonas y catálogo.
- Días 31 a 60: conectar las primeras dos o tres fuentes, implementar canalizaciones de ingesta por lotes, establecer políticas de acceso y cifrado.
- Días 61 a 90: habilitar las primeras consultas analíticas, validar la calidad de datos con usuarios finales y documentar linaje.
Las implementaciones que fracasan tienen un defecto en común: empezaron ingiriendo datos sin gobernanza ni catálogo. El lago creció sin orden y los usuarios dejaron de confiar en él.
Contar con un socio técnico de experiencia local ayuda a evitar esos errores desde el inicio. En EPAD Group SAS hemos acompañado a organizaciones colombianas de diversas industrias en la construcción de estas capacidades. Si está evaluando este tipo de proyecto, contáctenos: el primer paso es definir juntos sus tres casos de uso prioritarios.
El orden importa más que la tecnología
Implementar un lago de datos en un entorno de nube no es un proyecto de infraestructura. Es una decisión de arquitectura con consecuencias directas en cómo su empresa toma decisiones. Elegir bien la plataforma, diseñar las zonas desde el inicio, controlar la ingesta y aplicar gobernanza desde el día uno son las cuatro variables que separan un lago funcional de uno que nadie usa.
El primer paso no es elegir entre Azure y AWS. Es definir tres casos de uso concretos. Todo lo demás, la plataforma, los formatos, las canalizaciones, se construye sobre esa base.