
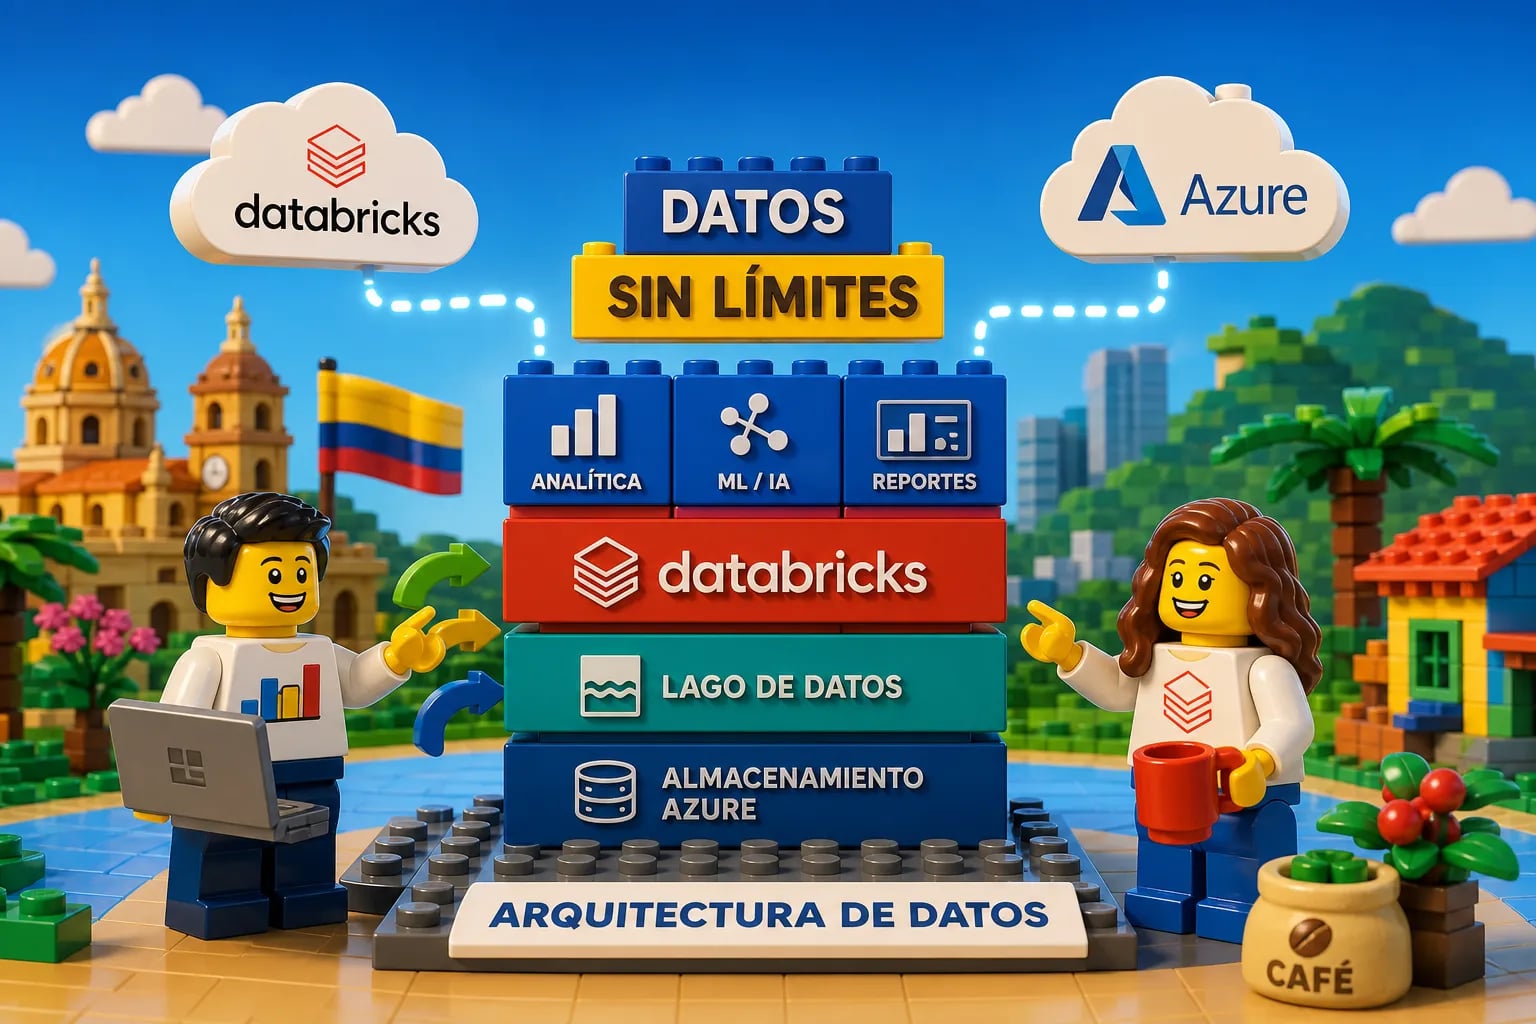

La arquitectura de datos para empresas medianas colombianas con Databricks y Azure permite unificar el ERP, el CRM, archivos planos y aplicaciones web en una sola capa que convierte información dispersa en decisiones concretas. El problema que enfrentan muchas organizaciones de tamaño medio no es la ausencia de datos: es que cada área opera con su propia versión de la verdad y los gerentes terminan apostando sobre intuición. Ese problema tiene un costo real, y lo hemos resuelto con una arquitectura bien diseñada desde el inicio.
En EPAD Group SAS hemos acompañado implementaciones de este tipo de arquitecturas en el mercado colombiano a lo largo de más de cinco años de trabajo con clientes en sectores como manufactura, distribución y servicios financieros. Lo que describimos aquí no es teoría de libro: es el diseño que recomendamos a nuestros clientes, con los componentes concretos, las decisiones técnicas que más impactan, un marco básico de estimación de costos y una hoja de ruta por fases para llegar a producción sin sorpresas.
Diseño de referencia: arquitectura lakehouse en Azure con Databricks
El modelo que mejor se adapta a las empresas de tamaño medio, por su equilibrio entre costo, escalabilidad y velocidad de implementación, es el lakehouse sobre Azure Data Lake Storage Gen2, organizado en tres zonas claramente separadas. Bronze recibe los datos tal como llegan de las fuentes, sin transformar. Silver aplica reglas de calidad, limpieza y estandarización mediante Azure Databricks. Gold contiene los modelos de negocio agregados que consume Power BI y otras aplicaciones. Esta separación evita el reprocesamiento y permite que distintos equipos reutilicen las mismas capas sin interferir entre sí.
Delta Lake es el formato que unifica todo el almacenamiento sobre ADLS Gen2. Aporta transacciones ACID, evolución de esquema y viaje en el tiempo: características esenciales en entornos de producción donde los datos cambian constantemente y los errores ocurren. La siguiente tabla muestra los servicios recomendados para cada capa del conjunto tecnológico.
| Capa | Servicio | Función |
|---|---|---|
| Origen | ERP, CRM, bases SQL, APIs | Sistemas que generan los datos |
| Ingesta por lotes | Azure Data Factory | Cargas periódicas desde sistemas operacionales |
| Ingesta en tiempo real | Azure Event Hubs | Captura de eventos continuos |
| Almacenamiento | ADLS Gen2 | Repositorio central Bronze/Silver/Gold |
| Procesamiento | Azure Databricks + Delta Lake | Transformación, modelado y control transaccional |
| Gobernanza | Unity Catalog | Permisos, metadatos y linaje de datos |
| Consumo | Power BI | Analítica y reportes de negocio |
Ingesta, orquestación y transformación: cómo hacer fluir los datos
El error más frecuente en proyectos medianos es cargar lógica de negocio compleja dentro de Azure Data Factory. ADF es un orquestador liviano: dispara flujos de trabajo, coordina dependencias y maneja reintentos. Databricks es el motor pesado: ejecuta toda la transformación con Spark SQL y notebooks (cuadernos de trabajo). En la práctica, el flujo sigue este orden: ingesta a Bronze, transformación a Silver, publicación en Gold, verificación de calidad y mantenimiento de archivos. Integrar ambas herramientas según ese rol evita cuellos de botella y facilita el diagnóstico cuando algo falla.
Patrones incrementales e idempotentes
Los procesos de ingesta deben ser incrementales e idempotentes. Incremental significa capturar solo los datos nuevos o modificados, usando marcas de agua o captura de cambios en la fuente, en lugar de recargas completas. Idempotente significa que cada escritura puede reejecutarse varias veces sin generar duplicados, lo cual resulta crítico cuando hay fallos parciales. Auto Loader, la herramienta nativa de Databricks para ingesta continua desde ADLS, simplifica considerablemente este patrón al detectar archivos nuevos de forma automática y gestionar la evolución del esquema. Para las cargas automatizadas en producción, los clústeres de tareas (Jobs Compute) son más baratos y más aislados que los clústeres interactivos: adoptarlos como opción predeterminada reduce costos y mejora la estabilidad del entorno.
Gobernanza, seguridad y la Ley 1581 de 2012
Unity Catalog centraliza permisos, metadatos y linaje sobre la estructura catálogo/esquema/tabla. Integrado con Microsoft Entra ID mediante sincronización automática de grupos (SCIM), aplica permisos por rol en lugar de por usuario individual. Cuando un colaborador cambia de área y ese cambio se refleja en el directorio corporativo, sus accesos se ajustan sin necesidad de intervención manual; si la sincronización no está configurada correctamente, ese paso sí requiere gestión explícita. Para una catalogación más amplia dentro del ecosistema de Azure, Microsoft Purview complementa Unity Catalog con clasificación y visibilidad a nivel organizacional.
En Colombia, la Ley 1581 de 2012 impone obligaciones directas cuando los datos personales se tratan en plataformas en la nube. Los requisitos mínimos incluyen:
- Autorización válida del titular
- Política de tratamiento publicada y accesible
- Mecanismos efectivos para consultas y supresión de datos
- Verificación del nivel de protección del país receptor cuando los datos salen del territorio colombiano
La transferencia a infraestructura en el extranjero solo es válida si ese país cumple estándares equivalentes a la normativa nacional. Como controles técnicos fundamentales: cifrado en tránsito y en reposo, principio de mínimo privilegio y auditoría continua de accesos.
Costos y hoja de ruta hacia producción
Presupuestar únicamente las unidades de procesamiento de Databricks es el error más común al estimar costos. El gasto mensual real se distribuye en cuatro bloques:
- Unidades de procesamiento según el tipo de carga y la edición contratada
- Máquinas virtuales por horas de clúster y número de nodos
- Almacenamiento en ADLS, incluyendo registros y el historial de Delta
- Red: NAT Gateway, egreso y Private Link cuando aplica
Para una primera estimación, agrega un margen de contingencia del 15 % al 30 %. Una vez en producción, la tabla system.billing.usage muestra el consumo real por servicio y permite ajustar el presupuesto con datos concretos.
Las tres fases hacia la producción
La ruta hacia una arquitectura de datos para empresas medianas colombianas con Databricks y Azure se estructura en tres fases diferenciadas. La fase piloto define el dominio de datos, monta el espacio de trabajo, conecta dos o tres fuentes a Bronze y valida la calidad en Silver; al final de esta etapa ya existe un flujo funcional con datos reales. La fase de expansión integra más fuentes, activa la gobernanza con Unity Catalog y conecta Power BI a Gold: aquí se ajustan costos con métricas reales y el equipo de negocio empieza a consumir resultados. Finalmente, la fase de producción automatiza la orquestación completa con ADF, habilita el monitoreo, documenta el linaje y formaliza los acuerdos de nivel de servicio. En cada una de estas etapas, EPAD Group SAS aporta consultoría especializada adaptada al sector y al volumen de datos de la organización.
La arquitectura de datos para empresas medianas colombianas: el diseño correcto evita meses de deuda técnica
El lakehouse sobre Azure con Databricks no es un proyecto de tecnología aislado: es la base operativa sobre la que las empresas medianas colombianas pasan de operar con intuición a operar con datos. Las decisiones que más impactan son la separación clara de capas Bronze/Silver/Gold, la ingesta incremental e idempotente, la gobernanza centralizada con Unity Catalog y el presupuesto completo con los cuatro bloques de costo.
Si buscas implementar una arquitectura de datos para empresas medianas colombianas con Databricks y Azure, el equipo de EPAD Group SAS puede acompañarte desde el diagnóstico inicial hasta la puesta en producción. Contáctenos para iniciar con una conversación sobre tu industria y tu volumen de datos actual, no con una propuesta genérica.