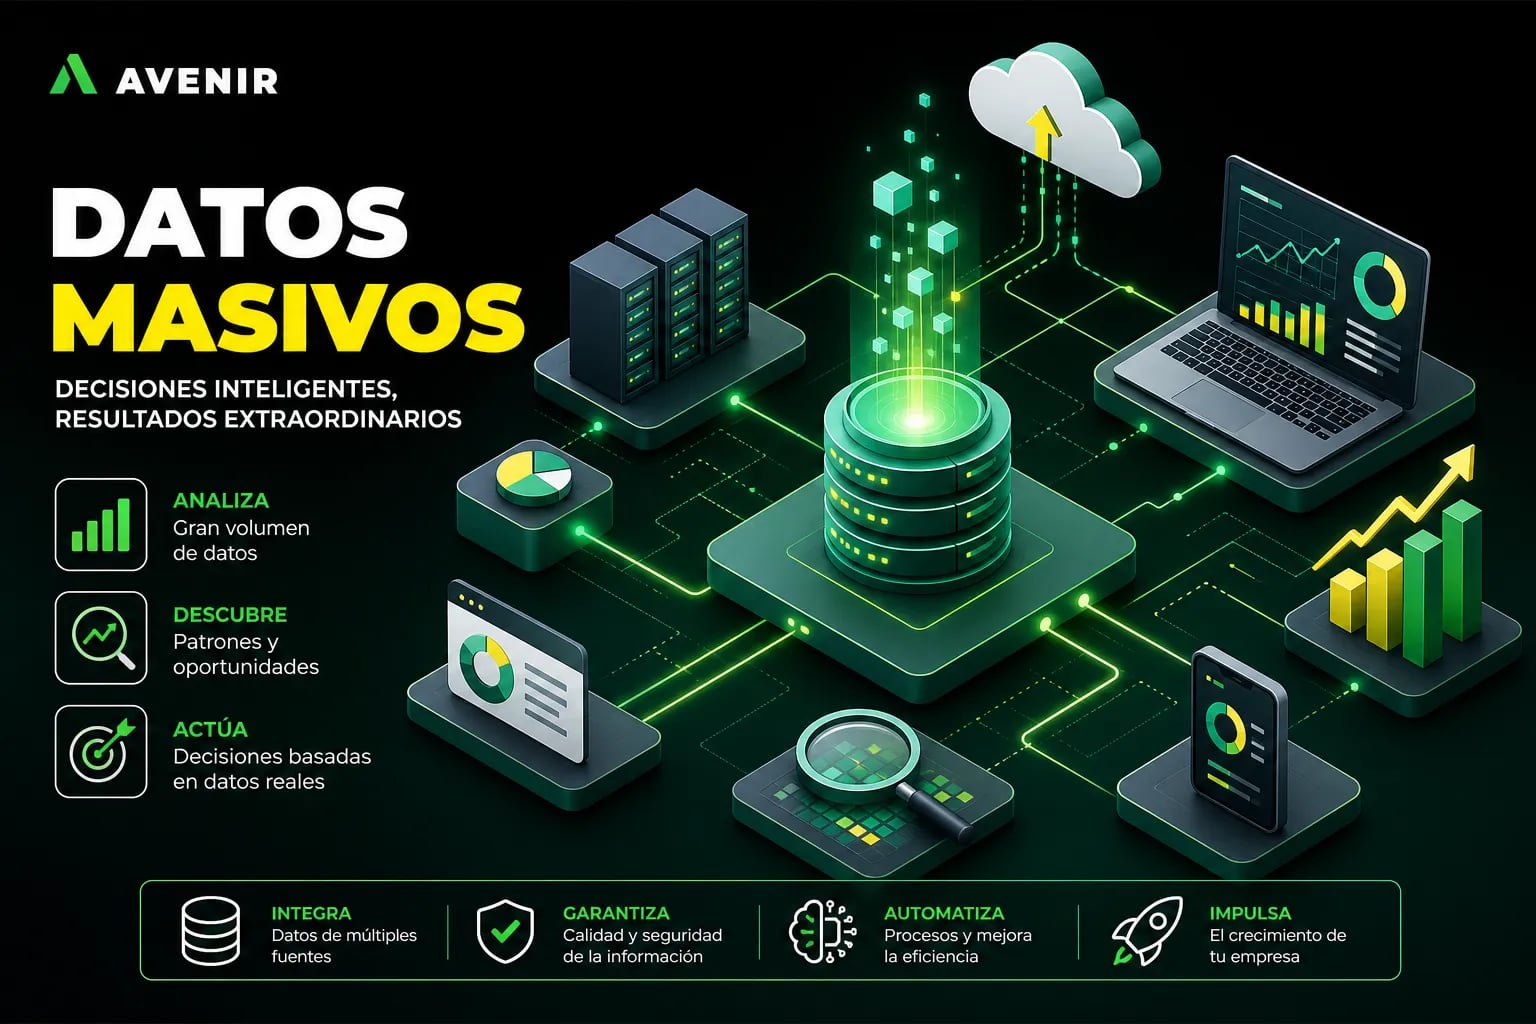
Las empresas colombianas generan más datos que nunca. Transacciones, pedidos, sensores, interacciones con clientes, registros logísticos: todo queda registrado. El problema no es la falta de datos; es que muchas organizaciones no tienen cómo procesarlos a tiempo ni convertirlos en decisiones concretas. En este artículo explicamos qué es el análisis de datos masivos, qué lo diferencia de un reporte convencional y cómo aprovecharlo en empresas colombianas que quieren tomar mejores decisiones con la información que ya tienen.
Cubrimos lo esencial: qué distingue un proyecto real de procesamiento a gran escala de un informe en Excel, qué plataformas existen y cuándo usar cada una, cómo luce el flujo completo desde el dato crudo hasta la decisión, y qué riesgos legales y presupuestales rara vez aparecen en las presentaciones de ventas.
Qué significa el análisis de datos masivos
El análisis de datos masivos no es simplemente «tener muchos datos en Excel.» Las herramientas clásicas se quiebran en tres situaciones concretas: cuando el volumen supera lo que una base de datos convencional puede procesar, cuando la velocidad de llegada es continua y cuando los datos llegan en formatos mixtos, texto, imágenes, señales de sensores y registros transaccionales al mismo tiempo, . En ese punto, las herramientas tradicionales dejan de ser suficientes.
Los casos reales ilustran mejor el problema. Un distribuidor que recibe millones de transacciones diarias enfrenta un reto de volumen; una planta manufacturera con sensores IoT emitiendo lecturas cada segundo enfrenta un reto de velocidad; una empresa logística con registros de despacho en decenas de formatos distintos enfrenta un reto de variedad. Los tres obstáculos suelen aparecer juntos, y superarlos exige una arquitectura diseñada para ello, no una hoja de cálculo más grande.
Las plataformas que hacen posible el procesamiento a gran escala
Hadoop, Spark y Databricks: cuándo usar cada uno
Hadoop, Apache Spark y Databricks son las tres referencias más frecuentes en este campo, pero no compiten directamente entre sí. Cada una ocupa un lugar distinto en la arquitectura. Hadoop almacena y procesa grandes lotes de datos de forma distribuida; es robusto y económico para volúmenes históricos. Spark ejecuta transformaciones en memoria, lo que lo hace considerablemente más rápido para analítica iterativa y modelos de aprendizaje automático. Databricks combina Spark con un entorno colaborativo y servicios administrados en la nube, reduciendo la carga operativa del equipo técnico.
Para una empresa mediana que está comenzando, no tiene sentido desplegar un clúster Hadoop propio. Los servicios administrados en Microsoft Azure, AWS o Databricks permiten escalar desde un piloto pequeño sin inversión inicial en servidores, una ventaja especialmente relevante para organizaciones que quieren validar el valor de la analítica de datos masivos antes de comprometer presupuesto, . La regla práctica es clara: cargas diarias con SQL y un almacén de datos administrado como punto de entrada; Spark y Databricks cuando el volumen y la complejidad lo justifiquen. La arquitectura debe crecer con el negocio, no adelantarse a él.
Flujo del análisis de datos masivos: del dato crudo a la decisión
Las etapas que nadie describe con honestidad
Un proyecto de analítica de datos masivos sigue un recorrido que pocas veces se describe con claridad. Primero viene la ingesta desde las fuentes: el ERP, los sensores, las interfaces de programación de aplicaciones, los archivos históricos. Luego, la limpieza y preparación de datos, que consume la mayor parte del tiempo y el esfuerzo. Después, el almacenamiento en zonas organizadas: datos crudos, datos depurados, datos listos para análisis. Solo entonces tiene sentido el modelado y la visualización.
Muchos proyectos no alcanzan el valor esperado por problemas en la preparación de datos, no en el algoritmo. Un modelo sofisticado aplicado sobre datos sucios produce decisiones equivocadas. Por esa razón, en EPAD Group SAS priorizamos la calidad del flujo completo antes de construir cualquier modelo predictivo.
Nuestro trabajo combina ingeniería de datos, analítica avanzada sobre plataformas como Databricks y Azure, e inteligencia artificial adaptada a la operación real de cada cliente. Conectar fuentes, validar información y construir canalizaciones de datos confiables es donde se gana o se pierde un proyecto de este tipo.
Las organizaciones que intentan construir esta capacidad por su cuenta suelen subestimar el esfuerzo de integración, gobierno y operación. No es únicamente un problema de talento; es también un problema de enfoque y de experiencia acumulada en proyectos anteriores. Quienes han transitado ese camino antes saben dónde están los puntos de falla reales.
Los retos que nadie menciona: gobernanza, privacidad y presupuesto
El análisis de datos masivos no ocurre en un vacío legal. En Colombia, la Ley 1581 de 2012 y el Decreto 1074 de 2015 establecen principios que cualquier proyecto de datos debe respetar desde el inicio: finalidad clara, autorización verificable, minimización del uso, seguridad proporcional y responsabilidad demostrada. La Superintendencia de Industria y Comercio puede investigar y sancionar. Un proyecto bien diseñado incorpora gobernanza y privacidad desde la primera línea de código, no como un paso final.
Existe además un riesgo que pocas presentaciones mencionan: los datos combinados de múltiples fuentes pueden reidentificar personas aunque cada fuente individual parezca anónima. Piense, por ejemplo, en el cruce de registros de ubicación con datos de compra y comportamiento en línea: por separado, ningún conjunto identifica a nadie; juntos, pueden hacerlo. Ese es un riesgo real en proyectos de minería de datos a gran escala, y exige evaluaciones de impacto antes de cruzar bases de datos de distintos orígenes.
En cuanto al presupuesto, un piloto bien delimitado en una empresa mediana puede costar entre 40 y 70 millones de pesos colombianos durante los primeros seis meses, rango orientativo que varía según el alcance, las fuentes de datos y las plataformas elegidas, más entre 1 y 4 millones mensuales de infraestructura en la nube. No es necesario comprar servidores propios ni desplegar toda la arquitectura desde el primer día. La recomendación concreta:
- Comenzar con un caso de uso acotado y una sola fuente de datos.
- Optar por cargas diarias en lugar de procesamiento en tiempo real.
- Involucrar entre cinco y diez usuarios de inteligencia de negocios.
- Escalar solo cuando el valor económico del piloto lo justifique con datos reales.
Para cerrar
El análisis de datos masivos no es un proyecto de tecnología; es una capacidad de negocio. Las empresas que empiezan con un caso de uso concreto, datos confiables y el equipo correcto avanzan. Las que esperan tener «todos los datos perfectos» antes de comenzar no avanzan nunca.
La pregunta concreta para tu organización es esta: ¿qué datos tienes hoy y qué decisión podría mejorar si los procesaras bien? La respuesta define el punto de partida de un piloto, no una arquitectura ideal ni una plataforma específica.
En EPAD Group SAS acompañamos a organizaciones colombianas en ese recorrido: desde identificar el caso de uso correcto hasta poner en producción flujos de datos confiables y analítica de datos masivos que realmente cambia decisiones. Si quieres evaluar dónde está tu empresa hoy, puedes ponerte en contacto con nuestro equipo.