Los datos de tu empresa viven en el ERP, en el CRM, en hojas de cálculo y en APIs externas que nadie conectó entre sí. Cuando llega el momento de consolidarlos para tomar una decisión, el proceso tarda días o semanas, y el resultado suele ser un archivo de Excel que alguien armó manualmente. El problema no es la cantidad de datos: es que no existe una capa central que los reciba, los organice y los ponga a disposición de quienes los necesitan.
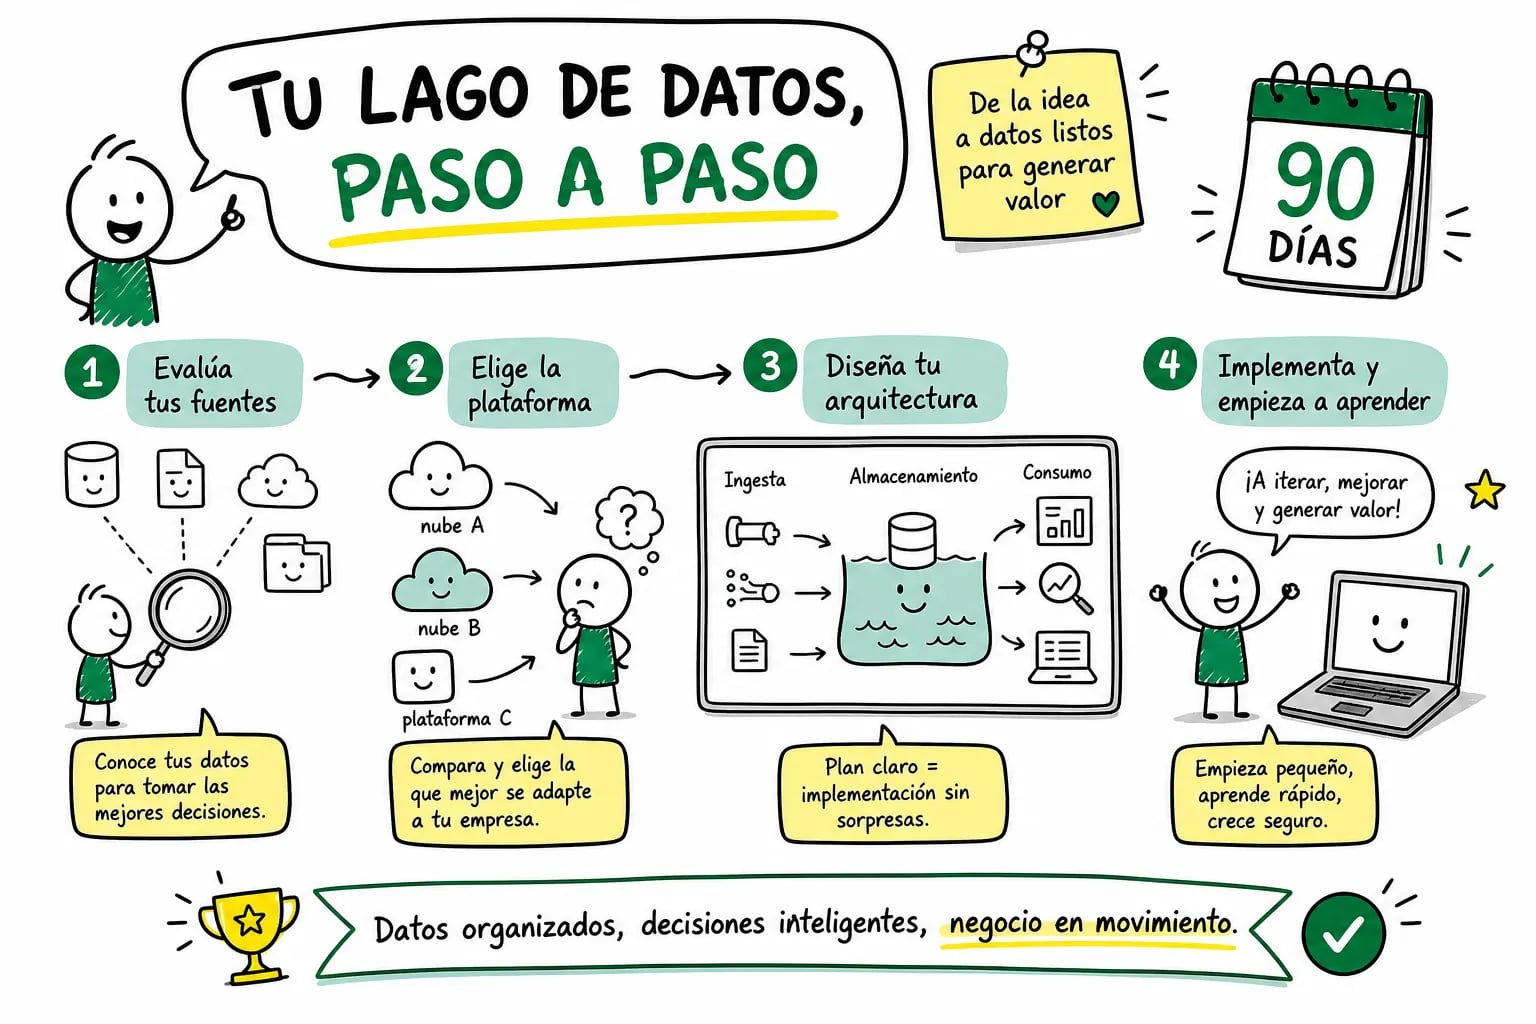
Un lago de datos resuelve exactamente eso. A diferencia de un almacén de datos tradicional, no exige definir una estructura rígida desde el inicio: recibe información en su formato original y la organiza progresivamente. En nuestra experiencia acompañando empresas colombianas, la pregunta más frecuente no es «¿qué es un lago de datos?» sino «¿por dónde empezamos?». Si buscas cómo implementar un lago de datos en tu empresa, lo que en el sector se conoce también como implementar data lake empresa, esta guía responde esa pregunta con pasos concretos: cómo evaluar las fuentes, elegir la plataforma, diseñar la arquitectura mínima, configurar los flujos de ingesta, establecer la gobernanza y ejecutar un plan realista de 90 días.
Evalúa tus fuentes antes de implementar un lago de datos en tu empresa
El error más común en estos proyectos es intentar conectar todas las fuentes al mismo tiempo. Eso garantiza retrasos, costos desbordados y un lago que nadie usa. En los proyectos que acompañamos, empezamos con tres a cinco fuentes prioritarias: generalmente el ERP, el CRM, archivos planos y una o dos APIs externas clave. Para cada fuente, documenta quién es el propietario del dato, en qué formato llega, con qué frecuencia se actualiza y cuánto volumen genera. Esa información define el tamaño de la infraestructura y el tipo de conectores que necesitas.
La elección de plataforma depende más del ecosistema que ya tienes que de una jerarquía de herramientas. Microsoft Fabric o Azure son la opción natural si la empresa ya usa Microsoft 365, Power BI y Entra ID: la integración nativa reduce la fricción desde el día uno. AWS ofrece un ecosistema amplio alrededor de S3 y Glue, con presencia regional en Latinoamérica y una comunidad de talento local en crecimiento. Los criterios decisivos son los requisitos regulatorios, el talento disponible en tu equipo y los sistemas heredados que debes conectar.
La arquitectura mínima viable: tres zonas, un solo flujo
Toda arquitectura de lago de datos funcional parte del mismo modelo de tres capas. La zona Cruda (Raw) almacena los datos originales sin ninguna modificación, con fecha de llegada y sistema de origen: es prácticamente inmutable. La zona Refinada (Silver) contiene datos normalizados, con esquema validado, duplicados eliminados y formatos estandarizados. La zona de Consumo (Gold) aloja modelos orientados al negocio, listos para conectar tu herramienta de inteligencia de negocios o una API de consulta.
Esta separación en capas permite reconstruir cualquier transformación y auditar el linaje de cada dato. Los componentes que no pueden faltar desde el primer día son: almacenamiento de objetos (S3 o ADLS Gen2), orquestador de flujos, motor de procesamiento SQL o Spark, catálogo básico, controles de calidad y gestión de accesos. El formato recomendado es Parquet como base; Delta Lake o Apache Iceberg cuando necesitas capacidad transaccional. Deja fuera de la primera versión el procesamiento en tiempo real, los modelos de aprendizaje automático y decenas de fuentes simultáneas: esas capacidades llegan en la siguiente etapa.
Ingesta y transformación: mover datos sin perder el control
Conectores y herramientas de ingesta
Para las fuentes prioritarias, las herramientas con mayor adopción en Latinoamérica en 2026 son Azure Data Factory y AWS Glue dentro de sus respectivos ecosistemas, Fivetran para conectores administrados que reducen la carga operativa, y Airbyte como alternativa de código abierto con menor costo de licencias. Empieza con cargas en lote diarias o varias veces al día. El procesamiento en tiempo real solo tiene sentido cuando el caso de uso exige latencia de segundos. La zona Cruda debe recibir los datos sin modificar, registrando siempre la marca de tiempo de llegada y el sistema de origen.
Frecuencia, formato y pruebas de calidad
Para las transformaciones entre capas, dbt se ha consolidado como el estándar práctico: permite transformar datos dentro del lago con pruebas, documentación y control de versiones integrados. Los controles mínimos de calidad por zona son validación de esquema y unicidad en la zona Refinada, y reglas de negocio junto con hechos y dimensiones en la zona de Consumo. Solo los conjuntos de datos de Consumo aprobados deben publicarse para uso en la herramienta de analítica o mediante APIs.
Gobernanza, seguridad y cumplimiento en Colombia
El catálogo de datos documenta origen, propietario, clasificación, calidad y consumidores de cada conjunto. Herramientas como Microsoft Purview, Unity Catalog de Databricks o Glue Data Catalog cubren esta necesidad según la plataforma que elijas. El modelo de control de acceso debe seguir el principio de mínimo privilegio: cuentas individuales, autenticación multifactor y revisión periódica de permisos. Para datos personales y sensibles que lleguen a las zonas Refinada y de Consumo, aplica enmascaramiento o tokenización.
En Colombia, la Ley 1581 de 2012 y el Decreto 1074 de 2015 establecen obligaciones concretas: identificar al responsable y al encargado del tratamiento, definir finalidades específicas y legítimas para cada uso del dato, obtener autorización previa e informada, y conservar evidencia de esa autorización. El lago debe poder atender los derechos del titular: acceso, rectificación y supresión. Revisa también la obligación de registrar bases de datos en el Registro Nacional de Bases de Datos ante la Superintendencia de Industria y Comercio. El cumplimiento cubre todo el ciclo de vida del dato, desde la ingesta hasta su eliminación verificable.
Plan de 90 días para implementar data lake empresa: hoja de ruta y presupuesto
Un lago de datos operativo es alcanzable en 90 días si limitas el alcance a un caso de uso concreto con dos o tres fuentes prioritarias, con un equipo dedicado y acceso oportuno a los sistemas de origen. Las fases se distribuyen así:
- Días 1 a 10: definir el caso de uso, las fuentes, la arquitectura y el equipo.
- Días 11 a 25: desplegar la base técnica: cuentas en la nube, redes, almacenamiento por zonas y controles de seguridad.
- Días 26 a 50: implementar los flujos de ingesta y los controles de calidad.
- Días 51 a 68: construir las capas Refinada y de Consumo, y conectar la herramienta de analítica.
- Días 69 a 80: puesta en operación: alertas, manuales operativos y revisión de costos.
- Días 81 a 90: pruebas de aceptación, formación del equipo y paso a producción.
Valida cada etapa en los días 10, 25, 50, 68 y 80 antes de avanzar. Esos puntos de control evitan arrastrar deuda técnica de una fase a la siguiente.
Para cinco a veinte terabytes de datos activos, los rangos de referencia orientativos son los siguientes (los valores varían según tasa de ingesta, número de consultas, nivel de servicio acordado y región):
- Nube (Azure, AWS o GCP): implementación entre US$50.000 y US$200.000; operación mensual entre US$4.000 y US$20.000.
- Infraestructura local: inversión inicial entre US$150.000 y US$500.000; operación mensual entre US$8.000 y US$30.000.
El almacenamiento representa solo entre el 5 % y el 15 % de la factura en la nube: el mayor costo proviene del procesamiento, las consultas y la orquestación. Como regla práctica, la nube gana en el primer año por agilidad y menor inversión inicial; la infraestructura local puede ser competitiva en un horizonte de tres a cinco años con cargas muy estables.
El siguiente paso es más sencillo de lo que parece
Cinco frentes de trabajo, un alcance delimitado y un equipo enfocado: ese es el modelo que funciona. Inventariar las fuentes y elegir la plataforma da claridad al diseño; la arquitectura en tres zonas y los flujos de ingesta con calidad incorporada sostienen la operación; la gobernanza desde el primer día protege los datos y garantiza el cumplimiento. Con ese orden, el primer caso de uso corre de extremo a extremo antes de que termine el tercer mes.
Cada empresa llega a este punto con un contexto diferente: distintos sistemas heredados, distintos equipos, distintas urgencias del negocio. En EPAD Group SAS acompañamos a empresas colombianas en cada etapa de este proceso, desde el diseño de la arquitectura y la selección de la plataforma, ya sea Azure, Microsoft Fabric o AWS, hasta la implementación de los flujos de ingesta, la gobernanza y la puesta en operación. Si quieres definir cómo implementar un lago de datos en tu empresa o necesitas un equipo especializado para arrancar, contáctanos y empezamos desde el día uno.