
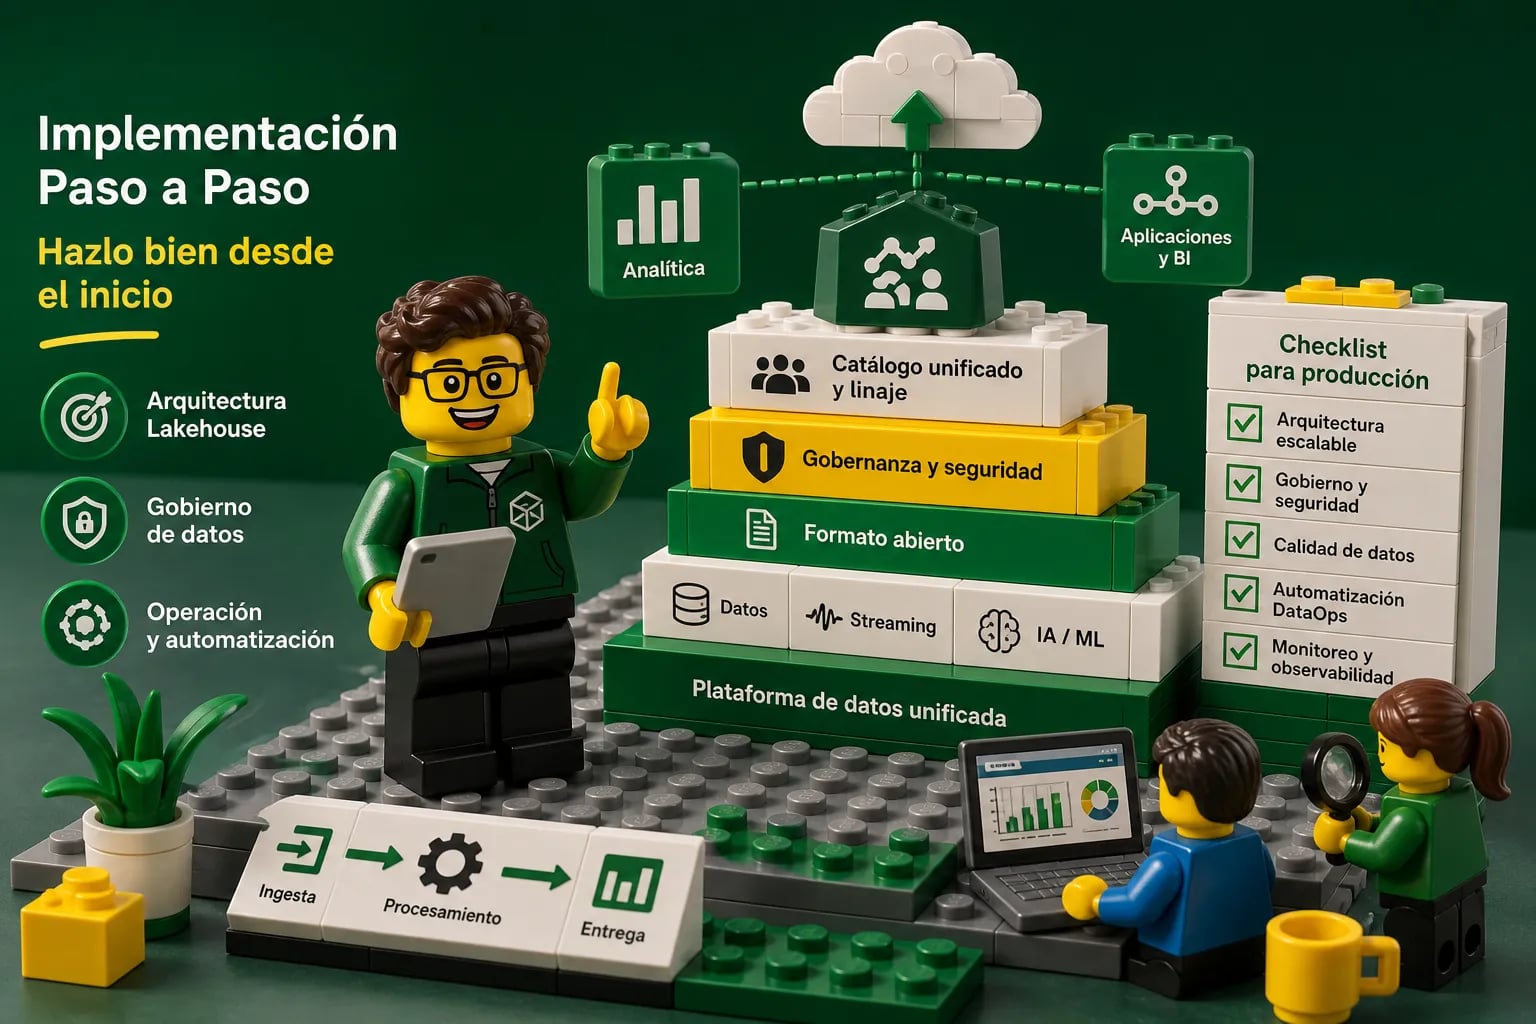
En nuestra experiencia, muchas empresas intentan implementar Databricks y, semanas después, tienen clústeres aislados, notebooks sin versionar y datos que nadie puede auditar. El problema no es la plataforma: es que la implementación comenzó en la consola sin haber tomado antes las decisiones de arquitectura, red, identidad y gobernanza. El resultado es técnicamente funcional pero operativamente frágil.
Esta guía recorre las decisiones críticas que determinan si una implementación de Databricks sostendrá cargas de trabajo de producción o se convertirá en deuda técnica. En EPAD Group SAS hemos acompañado este proceso en empresas colombianas de manufactura, servicios financieros y comercio; lo que aquí presentamos son lecciones de esos proyectos, no teoría. Cubrimos cuatro bloques: preparación de infraestructura, arquitectura de datos, gobernanza con Unity Catalog y DataOps hasta producción.
Preparación técnica para implementar Databricks
El despliegue de Databricks no empieza en la consola de Azure. Empieza en tres decisiones de infraestructura: permisos, red y almacenamiento.
Permisos mínimos de arranque
Quien crea el workspace necesita al menos el rol Contributor sobre la suscripción o el grupo de recursos, más permisos de red si la VNet ya existe y Databricks debe unirse a ella. Consulte la documentación oficial de Azure y Databricks para verificar los roles exactos según su configuración, incluido el rol Network Contributor cuando la red no está bajo la misma suscripción.
Red y almacenamiento
Para producción, se recomienda la inyección en una VNet propia: permite aplicar controles de salida, Private Link y Secure Cluster Connectivity sin exponer IP públicas en los nodos del clúster. Prepare dos subredes dedicadas, una para nodos de trabajo y otra para el controlador, con rangos CIDR que no se solapen con la red corporativa. El almacenamiento va en una cuenta Azure Data Lake Storage Gen2 con espacio de nombres jerárquico habilitado desde el inicio; activarlo después implica recrear la cuenta en la mayoría de los casos.
Nivel del workspace e identidad
El nivel del workspace condiciona las funciones disponibles desde el primer día. Standard no habilita Unity Catalog ni las políticas avanzadas de clúster: para cualquier entorno empresarial, Premium es el punto de partida correcto, como lo indica la tabla de funcionalidades publicada por Databricks. En cuanto a identidad, Microsoft Entra ID con inicio de sesión único y autenticación multifactor debe estar configurado antes de crear el workspace, no después. Las credenciales viven en Azure Key Vault, nunca dentro de notebooks ni parámetros visibles.
Arquitectura Lakehouse de Databricks: el patrón medallón
La arquitectura medallón organiza el lakehouse en tres zonas: bronce, plata y oro. No son carpetas con nombres de colores; son contratos de calidad progresiva. Bronce conserva los datos tal como llegan, con metadatos de origen, fecha de ingesta e identificador de proceso. Plata valida esquemas, elimina duplicados y normaliza. Oro publica datos orientados a consumidores concretos: tableros, modelos de aprendizaje automático o interfaces de programación.
En nuestra experiencia con implementaciones reales, el error más frecuente es usar las capas como directorios simples, sin contratos de esquema, sin reglas de calidad y sin propietarios definidos. El resultado es un pantano de datos con nombres de colores. La disciplina operativa importa más que la convención de nombres.
Delta Lake como formato transaccional es lo que hace que el patrón funcione: habilita versionado, evolución controlada de esquema y recuperación de errores desde la capa bronce hacia arriba. Para ingesta, el procesamiento por lotes sirve para cargas históricas y procesos periódicos; Auto Loader con transmisión continua es la opción adecuada para analítica operacional con baja latencia. Para organizaciones con múltiples unidades de negocio, el esquema radial sobre la arquitectura medallón permite combinar datos corporativos compartidos con productos de datos por dominio sin perder trazabilidad.
Gobernanza con Unity Catalog desde el primer día
Unity Catalog no es un componente que se configura después. Es el núcleo del gobierno de datos y debe estar activo antes de crear las primeras tablas de producción. La jerarquía es directa: un metastore por región, catálogos separados por entorno o dominio, y esquemas que siguen la estructura medallón.
La regla de oro de permisos es conceder siempre a grupos, nunca a usuarios individuales. Un grupo de lectores recibe USE CATALOG, USE SCHEMA y SELECT. Un grupo de ingenieros recibe además MODIFY. Nunca ALL PRIVILEGES salvo casos justificados y documentados, siguiendo el principio de mínimo privilegio que la propia documentación de Unity Catalog recomienda. Para trabajos automatizados, el modelo correcto son los service principals; las cuentas personales no tienen lugar en producción.
Para datos sensibles, los filtros de filas y las máscaras de columnas son una alternativa más robusta que crear copias depuradas de las tablas. Reducen la superficie de exposición y eliminan la necesidad de sincronizar dos versiones del mismo dato. El linaje de Unity Catalog resuelve otro problema concreto: saber qué canalizaciones leen o escriben cada tabla antes de modificar o retirar un activo. Los cambios a ciegas en producción son una de las causas más comunes de incidentes en plataformas de datos.
DataOps: puesta en producción de Databricks con Bundles y CI/CD
El flujo que lleva una canalización de desarrollo a producción de forma reproducible tiene una estructura clara: rama de funcionalidad, solicitud de revisión con pruebas automáticas, despliegue en entorno de pruebas, validación de datos de extremo a extremo y promoción aprobada a producción. Los Declarative Automation Bundles de Databricks son el mecanismo unificado para definir trabajos, canalizaciones y configuraciones por entorno en un archivo YAML versionado junto al código, tal como lo describe la documentación oficial de la plataforma.
Azure DevOps o GitHub Actions ejecutan este flujo de forma automatizada. La aprobación manual antes de producción es un control obligatorio: protege contra despliegues no revisados y es el último punto de verificación antes de que un cambio afecte datos reales. Los pasos de validación incluyen análisis estático de código (linting), pruebas unitarias de transformaciones y databricks bundle validate antes de cualquier despliegue.
Antes de activar cualquier carga de trabajo de producción, esta lista de verificación debe estar completa:
- Workspace configurado con inyección en VNet, Private Link y Secure Cluster Connectivity activos.
- Unity Catalog con metastore asociado, catálogos separados por entorno y permisos concedidos a grupos.
- Canalizaciones versionadas en Git con Declarative Automation Bundles y validadas en entorno de pruebas.
- Trabajos ejecutados con service principals, nunca con cuentas personales.
- Reglas de calidad de datos activas dentro de la canalización con alertas configuradas.
- Monitorización de ejecuciones, duración, fallos y costos de clúster activada antes del lanzamiento.
- Procedimiento de reversión documentado: versión anterior del bundle y tablas Delta versionadas.
Lo que sigue
El ciclo completo es: preparación de infraestructura, arquitectura medallón con Delta Lake, gobernanza centralizada con Unity Catalog y DataOps con Bundles y integración y entrega continuas. Cada bloque depende del anterior. Omitir uno no ahorra tiempo; solo desplaza el problema hacia la operación, donde resolverlo cuesta más.
Implementar Databricks correctamente no es una tarea de días. El tiempo real depende de factores como el número de fuentes de datos, el volumen de información, los requisitos regulatorios y la complejidad de la red; en proyectos empresariales típicos, el rango va de semanas a varios meses. Es, ante todo, una decisión de arquitectura que determina cómo la organización procesa, gobierna y consume datos durante años. Las decisiones que se toman al inicio, sobre red, identidad, niveles de workspace y estructura de catálogos, son difíciles de modificar en producción sin interrupciones.
El equipo de Ingeniería de Datos de EPAD Group SAS acompaña estas implementaciones en empresas colombianas, desde el diseño de la arquitectura hasta la puesta en producción de Databricks. Cada proyecto parte de los procesos reales de la organización: sus fuentes de datos, sus restricciones de red, sus requerimientos de seguridad y sus consumidores de información. Si su empresa está evaluando esta plataforma o tiene una implementación que necesita estabilizarse, contáctenos y conversamos sobre el punto de partida correcto para su caso.