
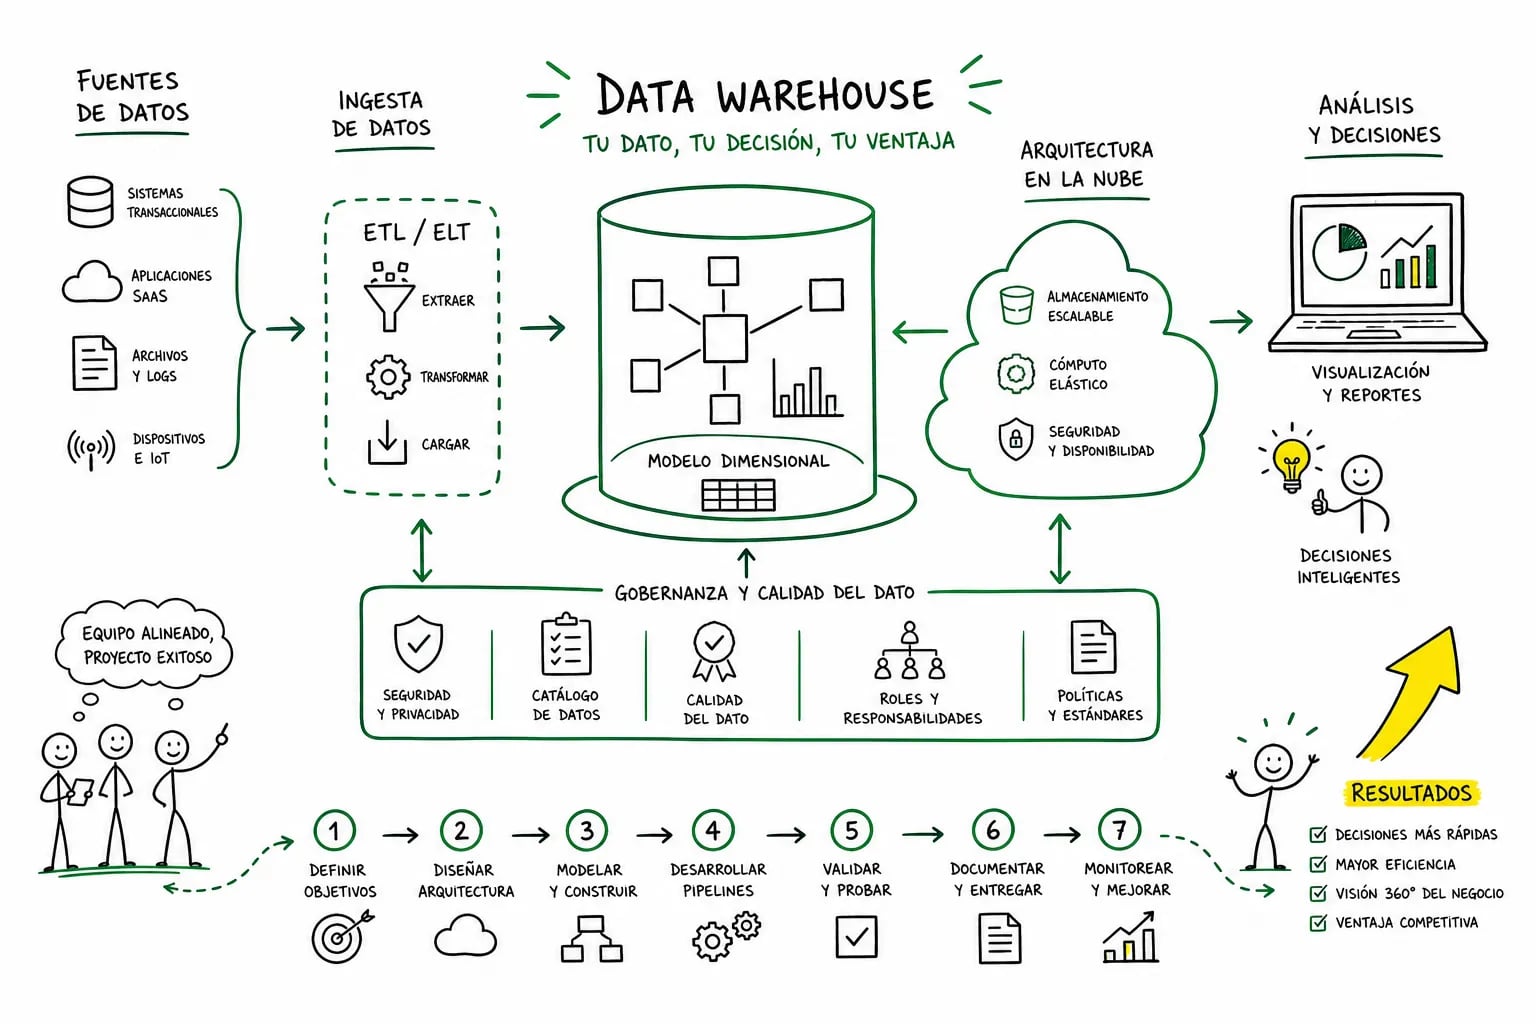
Las empresas medianas acumulan años de información en ERP, CRM, hojas de cálculo y sistemas aislados. El problema no es la falta de datos: es que esos datos no se pueden consultar juntos ni en el momento en que se necesitan. Un almacén de datos resuelve ese problema al centralizar, estructurar y poner la información a disposición del análisis. Si su empresa está evaluando cómo implementar un almacén de datos (o data warehouse, como se le conoce en el sector), este artículo presenta los pasos esenciales para hacerlo de forma ordenada, desde la arquitectura hasta el primer piloto en producción. Desde EPAD Group hemos acompañado a organizaciones colombianas en este proceso y aprendido algo que los proyectos de datos suelen pasar por alto: el orden de las decisiones importa tanto como las herramientas que se eligen.
Elige la arquitectura antes de elegir la herramienta
El error más frecuente al implementar un almacén de datos es seleccionar una plataforma por recomendación general y luego intentar adaptar los requisitos del negocio a esa elección. El camino correcto es el inverso. Para una empresa mediana que empieza en 2026, las arquitecturas en la nube son la opción preferida para la mayoría de implementaciones nuevas: menor costo de operación, escalado bajo demanda y sin servidores propios que administrar. Aun así, existen casos regulatorios o de arquitectura específica que justifican entornos locales o híbridos.
Cualquier diseño funcional necesita capas diferenciadas. Los datos llegan sin modificar a una zona de aterrizaje, se normalizan en una etapa intermedia, se integran en el núcleo del almacén y finalmente se exponen en modelos específicos por área. Esta separación no es un detalle técnico: es lo que permite reprocesar transformaciones sin perder el histórico original.
La selección de plataforma depende de cuatro variables: el ecosistema que ya usa la empresa, el volumen de datos, el perfil del equipo y el presupuesto disponible. A continuación, un panorama rápido de las opciones más frecuentes en Colombia:
- Microsoft Fabric: la opción más directa cuando la organización ya trabaja con Power BI, Microsoft 365 o Azure. OneLake unifica el almacén bajo una sola plataforma con gobierno centralizado.
- AWS: preferible cuando la empresa ya opera en ese ecosistema y necesita máxima flexibilidad entre lago y almacén.
- Databricks: destaca cuando el volumen es alto, los flujos de integración son complejos o el proyecto incluye aprendizaje automático.
- Snowflake: ofrece la experiencia SQL más simple y un escalado limpio entre almacenamiento y cómputo.
Para una empresa mediana colombiana con cinco a ocho fuentes y Power BI como herramienta de visualización, Fabric suele ser el punto de partida más eficiente dentro de su ecosistema.
Cómo implementar un almacén de datos: modelado y flujos de integración
El modelado dimensional es la base del análisis empresarial. Para un primer almacén, el esquema estrella funciona en casi todos los casos: una tabla de hechos central conectada a dimensiones descriptivas como fecha, cliente, producto y canal. Antes de cualquier otra decisión, hay que definir el grano de la tabla de hechos, es decir, qué representa exactamente cada fila. Si esa pregunta no tiene una respuesta clara y documentada, el modelo no está listo para construirse.
Modelado dimensional: por dónde empezar
Una regla práctica útil: comenzar con un proceso de negocio, una tabla de hechos y entre tres y cinco dimensiones, con la dimensión fecha incluida siempre. El esquema copo de nieve solo vale la pena cuando una dimensión tiene jerarquías muy complejas y la redundancia de datos es un problema real; en la mayoría de casos, añade uniones innecesarias sin ofrecer un beneficio medible. Esta recomendación es coherente con el enfoque iterativo que caracteriza los proyectos de almacén de datos exitosos: empezar pequeño, validar y luego ampliar.
Flujos de integración ELT y ETL
En cuanto a los flujos de integración, ELT es el punto de partida en la mayoría de arquitecturas modernas en la nube: cargar primero en bruto y transformar dentro del almacén con SQL o herramientas de modelado. ETL sigue siendo válido cuando los datos sensibles deben filtrarse o anonimizarse antes de llegar a la plataforma analítica. El patrón más frecuente combina ambos: extraer, aplicar enmascaramiento mínimo, cargar en una zona protegida y transformar dentro del almacén. Herramientas como Azure Data Factory, AWS Glue y dbt para transformaciones SQL cubren bien estos escenarios.
Establece gobernanza y calidad de datos antes de publicar
La gobernanza no es un paso posterior al desarrollo: es una condición de partida. Definir desde el inicio quién es responsable de cada fuente, cómo se clasifican los datos y qué roles tienen acceso a qué información son decisiones que deben tomarse antes de que el primer tablero llegue a un usuario. Sin responsables claros, la calidad se degrada con el tiempo sin que nadie lo note hasta que el daño ya está hecho.
El control de acceso debe incluir cifrado en tránsito y en reposo desde el primer día, junto con auditoría de consultas, cargas y cambios. Para la calidad de datos, el criterio de «listo para producción» es concreto: los totales del modelo dimensional cuadran con los sistemas de origen, los permisos están revisados y los umbrales de calidad definidos se han superado. Reconciliar totales antes de publicar no es opcional; es la única forma de garantizar que los usuarios confíen en los números que ven.
Conecta Power BI y lanza un piloto medible
El ciclo se cierra cuando los datos llegan a una decisión. Conectar Power BI directamente al almacén, en modo importación para mayor rendimiento, o en DirectQuery cuando la frecuencia de actualización lo exige, es el último paso técnico. Lo que se publica no deben ser copias desorganizadas de tablas, sino un modelo semántico certificado con las métricas que el negocio definió y con seguridad a nivel de fila configurada para los usuarios que tienen visibilidad restringida por región, línea de negocio o rol.
Un piloto bien acotado cubre un solo proceso de negocio, un conjunto de tableros validados por el área usuaria y un ciclo de carga automatizado. Sus resultados se miden con criterios definidos desde el inicio: tiempo de consulta, satisfacción del usuario, calidad de datos y reducción de informes manuales. Una vez que el negocio ve valor en ese primer dominio, escalar hacia nuevas fuentes y áreas se vuelve mucho más sencillo de justificar y ejecutar.
En EPAD Group acompañamos a empresas colombianas en todo este recorrido. Nuestro equipo atiende cada etapa por separado: el diseño de la arquitectura, el modelado dimensional, los flujos de integración sobre Azure, AWS, Databricks o Microsoft Fabric, y la conexión final con Power BI.
El almacén de datos como proceso, no como proyecto
Implementar un almacén de datos no es un lanzamiento único. Las organizaciones que lo hacen bien empiezan con un alcance pequeño, un modelo dimensional claro y controles de calidad desde el inicio, y amplían el sistema a medida que el negocio confirma el valor. La arquitectura importa y las herramientas importan, pero el orden de las decisiones es lo que determina si el proyecto llega a producción o se queda en una prueba sin continuidad. Si su empresa está evaluando cómo iniciar o escalar la implementación de su almacén de datos, el equipo de EPAD Group puede acompañarle desde el diagnóstico hasta la operación.