
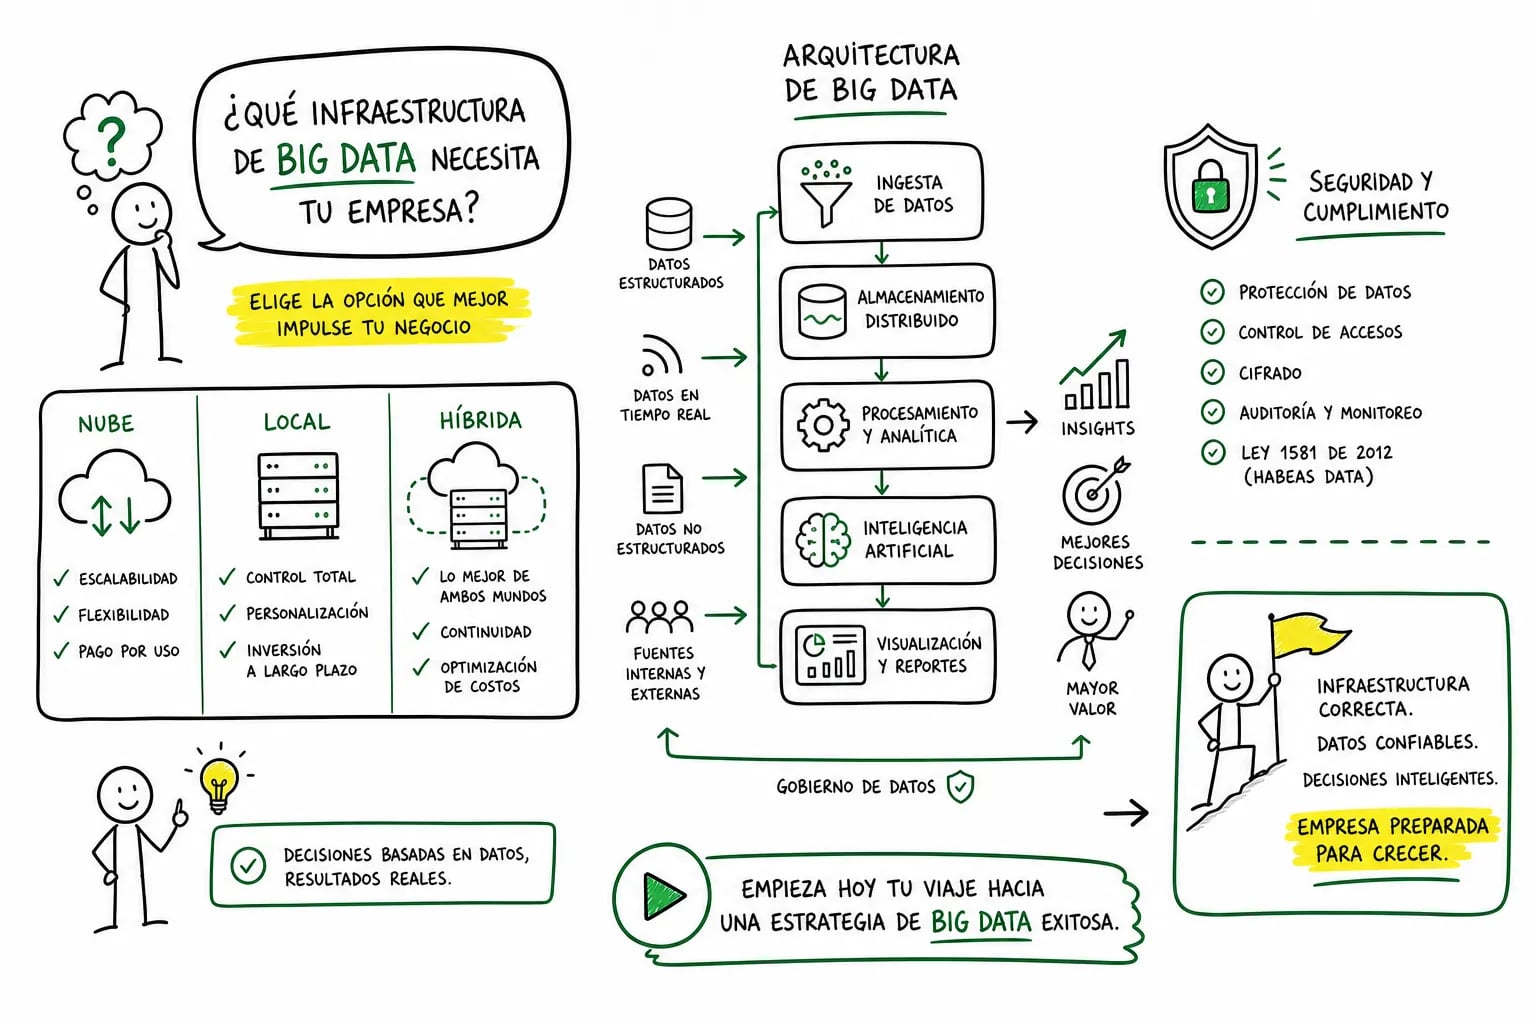
Si te preguntas qué infraestructura necesita una empresa colombiana para implementar Big Data, esta guía te da una respuesta concreta: los componentes esenciales, los modelos de despliegue disponibles, lo que exige la normativa colombiana y una estimación real de presupuesto. Cada mes, tu organización genera más datos: ventas, operaciones, clientes, proveedores, sensores. Pero esos datos viven dispersos en hojas de cálculo, sistemas ERP desconectados y bases de datos que ya no dan abasto. El problema no es la falta de información; es que no existe una infraestructura capaz de procesarla y convertirla en algo útil.
Empresas colombianas en sectores como manufactura, comercio minorista y servicios financieros ya están resolviendo este problema con socios tecnológicos especializados, sin necesitar un equipo interno grande dedicado exclusivamente a datos. Tienes opciones reales, con rangos de inversión muy distintos según tu punto de partida.
Qué infraestructura necesita una empresa colombiana para implementar Big Data: los componentes esenciales
Toda arquitectura de Big Data se sostiene sobre al menos tres bloques técnicos fundamentales: almacenamiento, procesamiento y gestión de datos con estructura variable. Es una visión simplificada que sirve como punto de entrada; en la práctica, una arquitectura madura también incluye capas de ingesta, orquestación y gobierno de datos. A continuación se describen los tres bloques base.
Almacenamiento: el data lake como repositorio central
Una base de datos relacional tradicional no está diseñada para manejar datos en múltiples formatos: transacciones estructuradas, registros de sensores semiestructurados o archivos de texto sin esquema fijo. Para eso existe el data lake, un repositorio central que acepta todos esos formatos sin imponer una estructura previa. Servicios como Amazon S3 o Azure Data Lake Storage son las opciones más accesibles para empresas medianas en Colombia; los costos operativos de una configuración mínima pueden partir desde aproximadamente USD 300 mensuales, aunque el monto final depende del volumen de datos y los servicios adicionales que se activen.
Procesamiento: por lotes y en tiempo real
La distinción clave aquí es entre procesar por lotes y procesar en tiempo real. Apache Spark es la herramienta más versátil para ambas tareas: análisis histórico, entrenamiento de modelos predictivos y transformación de datos de múltiples fuentes. Kafka actúa como un canal de mensajes que captura eventos en tiempo real; resulta especialmente útil para detección de fraude en banca, monitoreo de inventario en comercio minorista o alertas de maquinaria en manufactura. No es necesario implementar todo al mismo tiempo: la prioridad depende del caso de uso que más te urge resolver.
Bases de datos NoSQL: flexibilidad para datos con estructura variable
Cuando tienes datos con estructura variable, como perfiles de clientes, catálogos de productos o registros de eventos, herramientas como MongoDB o Cassandra ofrecen la flexibilidad que una base relacional no puede dar. Son especialmente útiles para lecturas rápidas y escrituras de alto volumen. Introducir el concepto de clúster desde esta etapa es importante: tanto Kafka como Spark operan en clústeres de nodos que trabajan en paralelo, y el dimensionamiento de esos clústeres afecta directamente el almacenamiento y la red.
Nube, local o híbrido: cuál modelo le conviene a tu empresa colombiana
La nube pública es el punto de entrada más práctico para empresas medianas colombianas. La inversión inicial es significativamente menor: rangos aproximados de USD 25.000 en nube frente a USD 300.000 en infraestructura local, aunque estos montos varían según el alcance del proyecto, las licencias y los servicios gestionados que se incluyan. Proveedores como AWS y Azure operan con cobertura regional que reduce la latencia y facilita el cumplimiento normativo. No compras servidores, no contratas personal de mantenimiento y escalas cuando lo necesitas, no antes.
La arquitectura híbrida tiene sentido en casos específicos: cuando ciertos datos deben permanecer en infraestructura propia por razones de cumplimiento o sensibilidad, y el procesamiento analítico puede llevarse a la nube. Sin embargo, lo híbrido añade complejidad real de integración. Sin un equipo especializado que gestione esa sincronización, los problemas concretos de latencia, gobernanza y consistencia de datos pueden superar los beneficios buscados. Para la mayoría de las medianas empresas colombianas, empezar en la nube pública y migrar cargas gradualmente es la ruta más eficiente.
Red y conectividad: el componente que más se subestima
La red es el cuello de botella más común en implementaciones que parecen bien diseñadas pero fallan en producción. Para un entorno inicial de Big Data, el mínimo recomendado es 1 Gbit/s de ancho de banda. Si el volumen crece o hay múltiples nodos del clúster procesando datos en paralelo, la red debe subir a 10 Gbit/s o más. Kafka y Spark son especialmente sensibles a picos de congestión y a la variación de latencia (conocida técnicamente como jitter); una red compartida con tráfico de usuarios o copias de seguridad arruina el rendimiento del clúster. Por eso conviene planificar la red con un margen de crecimiento de dos a tres veces desde el inicio, porque añadir redundancia de enlaces en el diseño original cuesta menos que hacerlo cuando ya tienes producción corriendo.
Ley 1581 y seguridad: lo que la normativa colombiana exige desde el día uno
La Ley 1581 de 2012 aplica a cualquier base de datos con información personal, y un proyecto de Big Data casi siempre procesa datos de personas identificables. Los controles técnicos mínimos que debes incorporar desde la arquitectura son: cifrado de datos en reposo y en tránsito, control de acceso por roles, registro de operaciones y trazabilidad, y mecanismos para suprimir o corregir datos cuando un titular lo solicite.
Además, el Decreto 886 de 2014 obliga a inscribir las bases de datos en el Registro Nacional de Bases de Datos (RNBD) administrado por la SIC. Si el proyecto incluye transferencia de datos a la nube o a terceros, el Decreto 1377 de 2013 también impone condiciones específicas que deben quedar reflejadas en contratos y configuraciones técnicas. Incorporar privacidad desde el diseño siempre es más barato que añadir controles retroactivamente.
Presupuesto real y cómo empezar con lo que tienes hoy
Los rangos de inversión varían según el modelo que elijas. En nube pública, la implementación inicial va de USD 25.000 a USD 80.000, con operación mensual desde USD 300 en configuraciones básicas. Una arquitectura híbrida requiere alrededor de USD 150.000 de inversión inicial, más costos de integración. La infraestructura local empieza en USD 300.000, con operación anual de USD 300.000 a USD 400.000, sin contar el personal especializado permanente. Estos rangos corresponden a proyectos de escala mediana y pueden variar según la composición específica de licencias, almacenamiento y servicios gestionados.
Para una empresa mediana colombiana, la nube pública elimina la barrera de entrada más alta: el capital inicial en equipos físicos. El tiempo de implementación de una plataforma básica en la nube oscila entre cuatro y doce semanas; una solución completa con ingesta, transformación y tableros de visualización toma entre tres y seis meses.
En EPAD Group SAS acompañamos a empresas colombianas a construir su infraestructura de Big Data sobre Azure y AWS partiendo de cero, sin que necesiten contratar un equipo interno especializado de planta. El enfoque es personalizado al contexto de cada organización, con atención disponible para resolver dudas y ajustes durante el proyecto. ¿Tu empresa ya tiene claro qué necesita para dar ese primer paso?
Para cerrar: la infraestructura de Big Data que tu empresa colombiana necesita, construida paso a paso
Definir qué infraestructura necesita una empresa colombiana para implementar Big Data es el primer paso para dejar de acumular datos sin poder usarlos. La buena noticia es que no tienes que resolverlo todo de una sola vez ni destinar cientos de miles de dólares en equipos desde el primer día. El almacenamiento en data lake, el procesamiento distribuido con Spark y Kafka, la red correctamente dimensionada y los controles de seguridad que exige la Ley 1581 se pueden construir de forma progresiva. El presupuesto se alinea a tu tamaño actual y crece con tu operación.
Si quieres empezar con claridad y sin decisiones apresuradas que después generen sobrecostos, ponte en contacto con el equipo de EPAD Group SAS. Te ayudamos a diseñar la arquitectura correcta para tu empresa y a dar el primer paso con resultados medibles.