
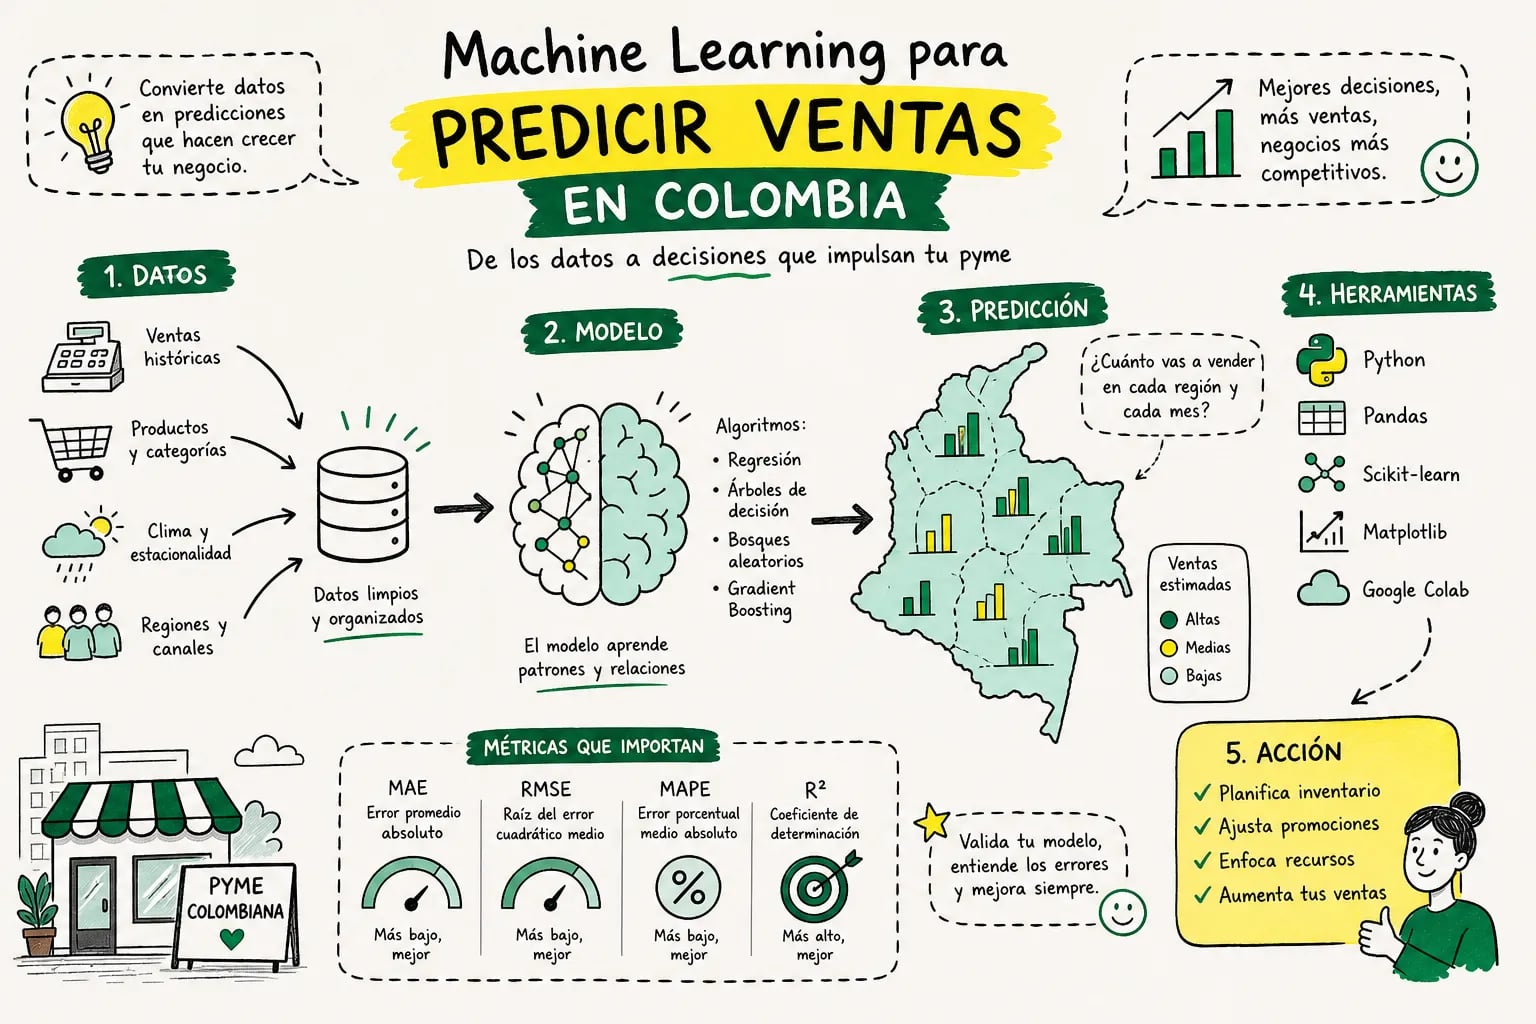
En Colombia, muchas empresas de retail, manufactura y servicios siguen planificando sus ventas con hojas de cálculo y la intuición del gerente. Con frecuencia, eso provoca exceso de inventario en temporada baja y quiebres de stock cuando el mercado despega, un ciclo costoso que existe una forma práctica de cortar. En este artículo explicamos cómo usar el aprendizaje automático (machine learning) para predecir ventas en empresas colombianas: qué datos recopilar, qué modelo elegir, cómo medir si funciona y cómo pasar del prototipo a producción.
El aprendizaje automático resuelve ese problema de forma concreta, no como concepto abstracto. En EPAD Group SAS hemos acompañado a empresas colombianas a construir modelos predictivos de ventas desde cero, y el proceso sigue siempre los mismos pasos fundamentales. Aquí los tienes.
Qué datos recopilar antes de escribir una sola línea de código
Las variables internas más importantes, por orden de prioridad, son: ventas históricas, promociones activas, precios e inventario. Las ventas históricas son la base del modelo; las promociones y los precios explican los picos que de otro modo parecerían ruido.
Para el contexto colombiano, las variables externas que más pesan son los festivos nacionales y regionales. Semana Santa, Amor y Amistad, Día de las Velitas y la temporada de fin de año pueden mover las ventas entre un 15% y un 30% en consumo masivo, aunque el rango exacto varía según la categoría y la localidad. Ignorarlos garantiza un modelo impreciso desde el primer día.
La frecuencia mensual es el punto de partida más robusto para una pyme. Reduce el ruido sin perder la estacionalidad. Antes de entrenar, distingue entre un mes con ventas en cero y un mes sin datos registrados: son dos cosas distintas y el tratamiento es diferente. Si encuentras un pico extraordinario, no lo borres sin verificar si fue una promoción o una temporada real. Eliminar ventas pico genuinas destruye la información estacional que el modelo necesita para funcionar.
Esta etapa de preparación, conocida como ingeniería de características, define en gran medida la calidad del modelo predictivo de ventas que obtendrás al final del proceso.
Cómo usar el aprendizaje automático para predecir ventas según los datos que tienes
La decisión es más sencilla de lo que parece. Si solo tienes la serie histórica de ventas, con festivos que afectan la demanda y algunos periodos con datos faltantes, Prophet es la opción más práctica para comenzar. Maneja bien la estacionalidad múltiple, tolera los cambios de tendencia y produce resultados interpretables sin mucho ajuste. Si la serie es estable y el horizonte de pronóstico es corto, entre uno y tres meses, ARIMA o SARIMA puede ser suficiente.
Cuando tienes muchas variables de negocio, como precio, canal de venta, región o tipo de cliente, XGBoost es una apuesta sólida. Convierte el problema de series temporales en un problema supervisado usando variables de rezago, promedios móviles y estacionalidad codificada. En empresas con datos de ERP o sistemas de punto de venta que incluyen múltiples atributos por transacción, XGBoost suele superar a Prophet porque captura interacciones no lineales entre variables.
La regla práctica es esta: si solo dispones de la serie histórica, usa Prophet o ARIMA. Si cuentas con muchas variables de negocio, XGBoost es el camino. Esta distinción es el núcleo de cualquier estrategia para usar el aprendizaje automático en el pronóstico de ventas de una empresa colombiana.
Cómo saber si el modelo sirve o no
En el pronóstico de ventas, nunca se divide el conjunto de datos de forma aleatoria. El orden temporal es la esencia del problema. Como ejemplo ilustrativo: si tienes ventas registradas entre 2021 y 2025, entrenas con los datos de 2021 a 2024 y evalúas el modelo contra los datos reales de 2025. Hacer esa división al azar inflaría artificialmente las métricas y el modelo fallaría en producción.
Para medir el error, usa tres métricas en paralelo:
- MAPE (error porcentual medio absoluto): la métrica principal para comparar el modelo entre productos o canales. No lo uses cuando hay muchos periodos con ventas en cero.
- MAE (error absoluto medio): te dice cuántas unidades está fallando el modelo en promedio. Es la cifra más interpretable para presentar a la gerencia.
- RMSE (raíz del error cuadrático medio): penaliza los errores grandes. Útil para detectar modelos que fallan poco en promedio pero generan desvíos muy costosos en algunos meses.
En retail y consumo masivo de alta rotación, un MAPE por debajo del 15% es un buen resultado. En comercio electrónico con promociones frecuentes, hasta un 25% puede ser aceptable. Si el error supera el 30%, el modelo o el nivel de agregación necesita revisión.
El conjunto de herramientas y lo que cuesta en Colombia
Python 3.11 es el lenguaje base. Las librerías que necesitas para arrancar son: pandas y numpy para preparación de datos, statsmodels para ARIMA, prophet para series con festivos, scikit-learn para validación y métricas, y xgboost cuando hay muchas variables. Para visualización, Power BI si la empresa ya lo usa; Streamlit para un tablero propio y liviano.
El software es prácticamente gratuito. El costo real está en el tiempo de implementación y la infraestructura. Una solución local, ideal para pymes que ejecutan el pronóstico una vez a la semana, puede costar entre 500.000 y 5.000.000 COP si ya cuentas con equipo técnico interno. Si necesitas automatización, acceso multiusuario o integración con otros sistemas, la nube es la opción correcta: una instancia básica en Azure o AWS arranca alrededor de USD 20 al mes según la configuración, y una solución productiva completa con monitoreo puede costar entre 8 y 25 millones de COP en implementación inicial con un socio externo. Estos rangos varían con el tiempo y según los requerimientos específicos de cada proyecto.
Cómo llevar el modelo a producción sin que quede atrapado en un prototipo
Un modelo que vive en un cuaderno de Jupyter no le sirve al negocio. Para que opere de forma autónoma, necesitas resolver tres frentes:
- Conectar la ingesta de datos al ERP o sistema de punto de venta para que las ventas lleguen actualizadas sin intervención manual.
- Programar el reentrenamiento periódico del modelo, con una cadencia que depende de la volatilidad del negocio: un mercado con demanda estable puede tolerar revisiones trimestrales, mientras que uno con alta variabilidad requiere ciclos más cortos.
- Monitorear el MAPE en producción para detectar a tiempo cuándo el mercado cambia y el modelo necesita ajuste.
Construir y mantener todo eso al mismo tiempo requiere habilidades en ciencia de datos, ingeniería de datos y conocimiento profundo del negocio. La mayoría de pymes colombianas no tiene ese equipo internamente, y no tiene por qué tenerlo.
EPAD Group SAS es una empresa colombiana especializada en aprendizaje automático e inteligencia artificial para organizaciones de todos los tamaños. Ha implementado modelos predictivos de ventas en sectores como retail, manufactura y servicios, acompañando todo el proceso: desde la limpieza de datos históricos hasta el despliegue en nube y el monitoreo continuo del modelo.
Por dónde empezar si quieres predecir ventas con aprendizaje automático
Usar el aprendizaje automático para predecir ventas en empresas colombianas no requiere un equipo enorme ni una infraestructura costosa desde el día uno. Lo que sí requiere es orden: datos históricos limpios y bien estructurados, un modelo adecuado al tipo de información disponible, y métricas claras para saber si el pronóstico es confiable.
El primer paso no es elegir el algoritmo, es revisar la calidad de los datos históricos de ventas. Si eso ya está listo, el modelo predictivo de ventas puede estar funcionando en semanas, no en meses. Si quieres recorrer ese camino con un equipo que ya ha pasado por este proceso en empresas colombianas, escríbenos a EPAD Group SAS y revisamos juntos el estado de tus datos históricos.