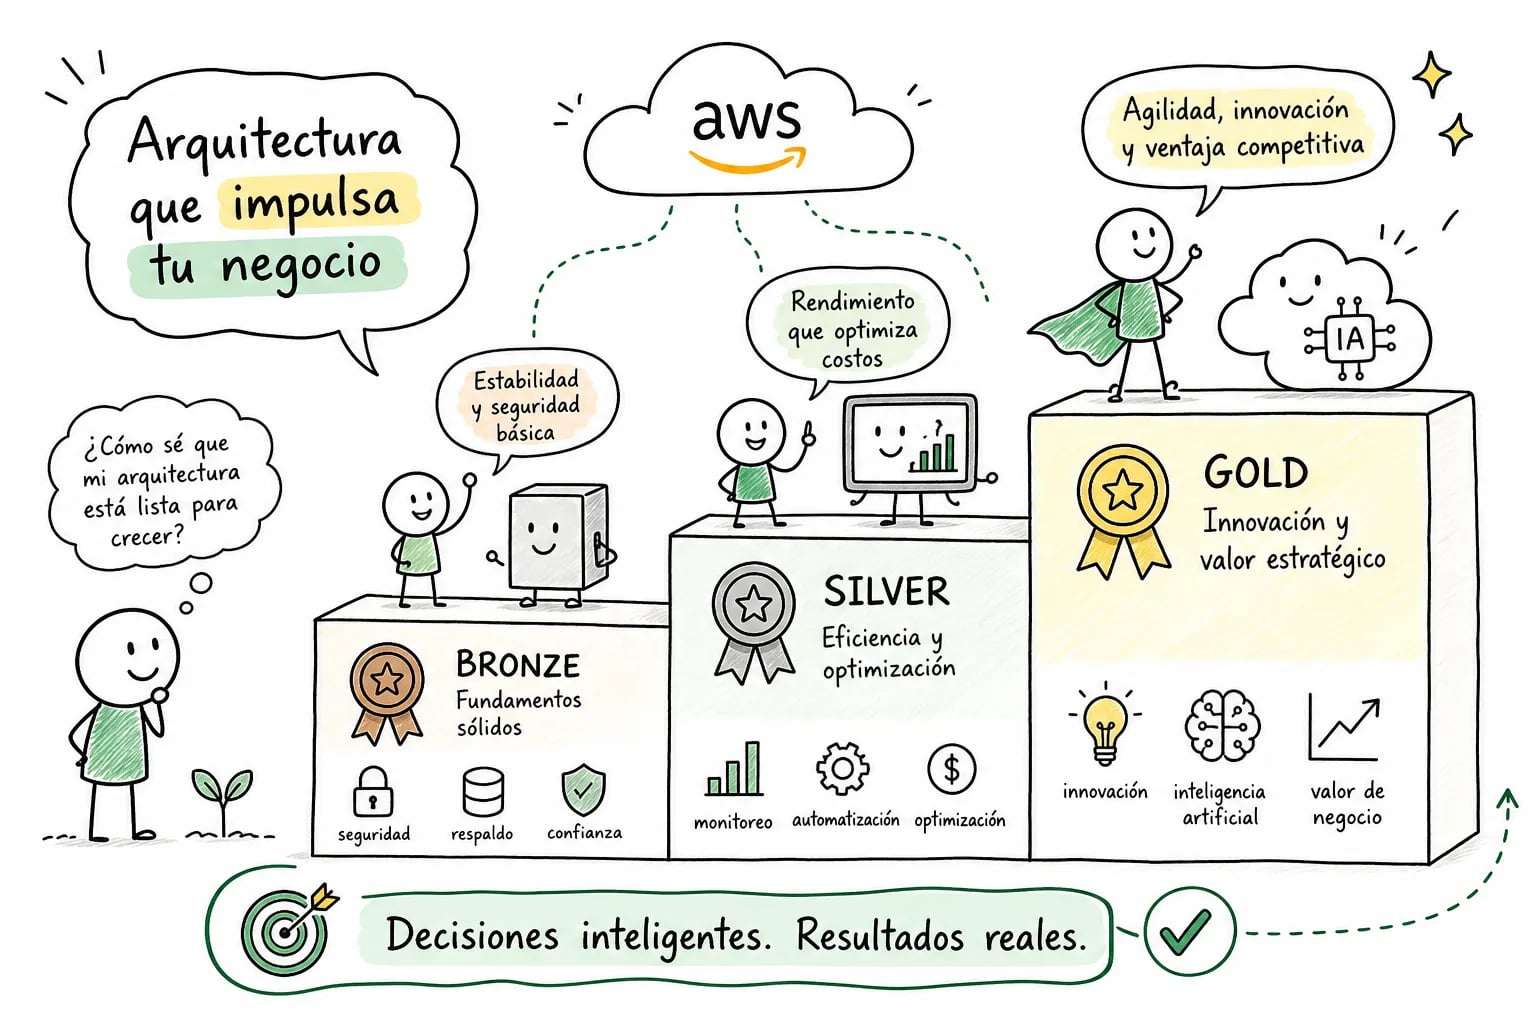
La arquitectura medallón en AWS organiza los datos en tres capas secuenciales: Bronce conserva el dato original tal como llega, Plata lo limpia y estandariza, y Oro lo prepara para análisis y toma de decisiones. No es una tecnología específica, sino un patrón de diseño que funciona sobre servicios como Amazon S3, AWS Glue y Amazon Redshift. Muchas organizaciones con grandes volúmenes de datos están adoptando este modelo para pasar de información dispersa y poco confiable a plataformas estructuradas, auditables y escalables; en Colombia, ese cambio es cada vez más evidente en sectores como manufactura, distribución y servicios financieros. En EPAD Group SAS diseñamos e implementamos estas arquitecturas sobre AWS para organizaciones que necesitan exactamente eso.
Puntos clave
- Bronce es la fuente de verdad: almacena el dato crudo e inmutable, con metadatos de ingesta, para poder reprocesar desde cero si algo falla aguas abajo.
- Plata valida antes de publicar: aplica deduplicación, tipado canónico y reglas de negocio. Sin una capa de Plata confiable, los datos en Oro carecen de fundamento: cualquier discrepancia de unicidad o de métricas se arrastra directamente a los reportes.
- Oro es la superficie principal de consumo empresarial: tablas agregadas, dimensiones y métricas optimizadas para reportes, tableros de control y modelos de aprendizaje automático. El acceso a capas inferiores debe estar restringido y justificado.
- S3 + Glue es la columna vertebral: Amazon S3 almacena las tres capas; AWS Glue ejecuta las transformaciones entre ellas mediante tareas PySpark administradas. Amazon EMR es una alternativa válida cuando se requiere mayor control del entorno de ejecución o rendimiento a mayor escala.
- Apache Iceberg agrega valor en Plata y Oro: transacciones ACID, evolución de esquema, consultas sobre versiones históricas de los datos y escrituras incrementales que Parquet simple no ofrece.
- Lake Formation gobierna todas las capas: permisos por tabla y columna, auditoría centralizada y separación estricta de roles de escritura por capa.
¿Qué hace cada capa de la arquitectura medallón?
Bronce: el dato tal como llega a la plataforma
Bronce es la capa de aterrizaje. Los datos llegan en su formato original, ya sea JSON, CSV o binario, y no se modifican. Esta inmutabilidad es su principal valor: si un proceso aguas abajo falla o produce un resultado incorrecto, Bronce permite reprocesar desde cero sin depender del sistema fuente original. Cada objeto en Bronce debe registrar al menos el timestamp de ingesta, el sistema de origen, el identificador de lote y el resumen criptográfico del contenido para garantizar trazabilidad completa.
Plata: datos validados y listos para analizar
Plata es donde ocurre la transformación real. Se aplican deduplicación, tipado canónico, estandarización de campos y eliminación de registros inválidos. Los datos de Plata son confiables para equipos de datos y analítica. Plata no reemplaza Bronce: lo complementa. Un fallo en las reglas de calidad de Plata debe impedir la promoción de datos a Oro, no silenciarse como una advertencia.
Oro: información lista para el negocio
Oro contiene tablas agregadas, dimensiones, métricas y conjuntos de datos optimizados para reportes, tableros de control y modelos de aprendizaje automático. Es la superficie que los usuarios de negocio deben consumir directamente; el acceso a capas inferiores debe estar controlado y obedecer a casos excepcionales como exploración técnica o diagnóstico. Si un analista necesita recurrir a Plata para responder una pregunta de negocio, el diseño de Oro tiene un problema.
¿Cómo se implementa la arquitectura medallón en AWS?
Amazon S3 como almacenamiento base de las tres capas
S3 es la columna vertebral de la arquitectura medallón en AWS. La convención habitual es un bucket o prefijo por capa: lake-bronce/, lake-plata/ y lake-oro/. El particionado recomendado separa la fecha de ingesta de la fecha del evento: la primera permite localizar lotes concretos para reprocesos; la segunda sirve para análisis. En Bronce se activa el versionado de objetos de S3 para proteger el dato original frente a sobrescrituras accidentales. Para Plata y Oro, Apache Iceberg es el formato de tabla recomendado: aporta transacciones ACID, evolución de esquema y consultas sobre versiones históricas de los datos sobre los mismos archivos Parquet en S3.
Una plantilla mínima en CloudFormation para desplegar los tres buckets con versionado y cifrado puede verse así:
AWSTemplateFormatVersion: '2010-09-09'
Resources:
  BronzeBucket:
    Type: AWS::S3::Bucket
    Properties:
      BucketEncryption:
        ServerSideEncryptionConfiguration:
         , ServerSideEncryptionByDefault:
              SSEAlgorithm: AES256
      VersioningConfiguration:
        Status: Enabled
      PublicAccessBlockConfiguration:
        BlockPublicAcls: true
        BlockPublicPolicy: true
        IgnorePublicAcls: true
        RestrictPublicBuckets: true
  SilverBucket:
    Type: AWS::S3::Bucket
    Properties:
      VersioningConfiguration:
        Status: Enabled
  GoldBucket:
    Type: AWS::S3::Bucket
    Properties:
      VersioningConfiguration:
        Status: Enabled
AWS Glue para transformar datos entre capas
Glue es el motor ETL administrado que ejecuta las tareas PySpark de Bronce a Plata y de Plata a Oro. El Catálogo de Datos de Glue registra las tablas y los rastreadores de esquema descubren estructuras automáticamente. AWS Step Functions puede orquestar la secuencia de tareas para garantizar que Oro solo se construya después de que Plata haya pasado los controles de calidad. Una tarea típica de Bronce a Plata aplica limpieza, deduplicación y particionado:
df = (
    spark.read.json("s3://lakehouse-bronze/events/")
    .dropDuplicates(["event_id"])
    .withColumn("event_ts", to_timestamp("event_ts"))
    .filter(col("event_id").isNotNull())
    .withColumn("year", year("event_ts"))
    .withColumn("month", month("event_ts"))
)

df.write.mode("overwrite").format("parquet") \
  .partitionBy("year", "month") \
  .save("s3://lakehouse-silver/events/")
Athena y Redshift para servir la capa Oro
Athena permite consultas SQL directamente sobre S3 e Iceberg sin mover datos, lo que la hace adecuada para acceso exploratorio o esporádico. Redshift es la opción apropiada cuando existen tableros de control con tiempos de respuesta estrictos, cargas dimensionales recurrentes o alta concurrencia de usuarios. Un patrón frecuente es mantener el histórico de Oro en S3 y consultar con Athena, mientras se cargan en Redshift solo los agregados con acceso frecuente. Lake Formation actúa como plano de gobierno, aplicando permisos por tabla y columna sobre ambos motores.
¿Qué gana una empresa al adoptar la arquitectura medallón en AWS?
Trazabilidad completa y capacidad de reprocesar desde el origen
Bronce inmutable elimina uno de los problemas más frecuentes en empresas con datos sin orden: la incapacidad de auditar o reproducir un resultado. Si un reporte está mal, se puede reconstruir Plata y Oro desde Bronce sin llamar al sistema fuente original. Esto puede reducir de forma significativa el tiempo de resolución de incidentes en producción, al eliminar la dependencia de sistemas externos y la búsqueda manual de versiones anteriores de los datos.
Datos confiables para reportes y decisiones operativas
Cuando Plata aplica reglas de calidad antes de promover datos a Oro, los analistas y gerentes trabajan sobre información validada. Esto elimina las discrepancias entre reportes de distintas áreas y acaba con las reconciliaciones manuales. Es un problema frecuente en empresas que no cuentan con plataformas de datos integradas: múltiples versiones de la misma cifra en distintos archivos o sistemas desconectados. La arquitectura medallón en AWS aborda exactamente esa situación.
Gobernanza y calidad de datos por capa
Controles de calidad en cada transición entre capas
La capa Bronce valida legibilidad y completitud del lote. Plata aplica tipos canónicos, deduplicación y reglas de negocio. Oro reconcilia métricas contra Plata antes de publicar. Un fallo de calidad crítico debe bloquear la promoción; las alertas deben registrarse como datos, no solo como entradas en un registro de eventos que nadie revisa. Lake Formation centraliza los permisos por tabla y columna, y los roles de escritura en cada capa son estrictamente separados: ningún consumidor debe poder escribir directamente en Plata ni en Oro.
Linaje y auditoría: saber qué ocurrió con cada dato
Cada ejecución debe generar un manifiesto con entradas, salidas, versión del código, identidad y métricas de calidad. Esto permite responder preguntas de auditoría sin buscar en registros dispersos: qué tarea transformó ese registro, cuándo llegó y qué regla lo rechazó. CloudTrail registra la actividad de acceso y el Catálogo de Datos de Glue funciona como registro central de metadatos para todas las capas.
Cómo EPAD Group implementa la arquitectura medallón en AWS con empresas colombianas
Diseño adaptado a los datos y procesos reales de cada organización
En EPAD Group no existe una plantilla única. El proceso parte del diagnóstico de la plataforma actual, la identificación de los dominios de datos y la selección de los servicios AWS más apropiados para cada capa. Trabajamos con AWS Glue, S3, Redshift, Athena, Lake Formation y Apache Iceberg según el volumen, la latencia requerida y los consumidores finales de cada organización. El diseño correcto de cada capa importa más que la elección de servicios.
De datos dispersos a una plataforma estructurada y escalable
Organizaciones que antes dependían de hojas de cálculo, reportes manuales y sistemas desconectados pueden consolidar una plataforma de datos con calidad, gobierno y analítica integrada. El resultado no es solo tecnología: es la capacidad de tomar decisiones con información confiable, reproducible y auditable. Si quieres evaluar tu arquitectura actual o iniciar una implementación de arquitectura medallón en AWS, el equipo de EPAD Group SAS está disponible para acompañarte desde el diagnóstico hasta la operación en producción, con experiencia técnica en ingeniería de datos y conocimiento de los procesos empresariales reales de las organizaciones colombianas.
El patrón es simple; la ejecución requiere disciplina
Bronce conserva, Plata valida, Oro publica. AWS ofrece los servicios para implementar cada capa sin necesidad de infraestructura propia. La arquitectura medallón en AWS no es exclusiva de empresas de tecnología: es el camino que están tomando organizaciones de manufactura, distribución, comercio minorista y servicios en Colombia para hacer que sus datos trabajen para ellas.
El valor no está en los servicios de AWS. Está en el diseño correcto de cada capa, en los controles que garantizan que Oro refleja datos confiables y en la disciplina operativa para mantener Bronce inmutable y las transformaciones idempotentes. Sin eso, tienes buckets bien nombrados pero el mismo problema de siempre. Contáctanos en EPAD Group SAS para evaluar si esta arquitectura es el paso correcto para tu empresa.
Preguntas frecuentes
¿Qué servicios de AWS se recomiendan para implementar la arquitectura medallón?
Recomiendo usar Amazon S3, AWS Glue, Apache Iceberg, Athena, Amazon Redshift y Lake Formation según el caso. S3 almacena las tres capas, Glue ejecuta las transformaciones PySpark, Iceberg aporta transacciones y evolución de esquema en Plata y Oro, Athena permite consultas directas sobre S3 e Iceberg, Redshift sirve cargas con SLA estrictos, y Lake Formation gobierna permisos y auditoría.
¿Cuándo conviene usar Apache Iceberg en lugar de solo archivos Parquet?
Conviene usar Apache Iceberg en Plata y Oro cuando se necesitan transacciones ACID, evolución de esquema y consultas sobre versiones históricas. Iceberg añade capacidades de escritura incremental y control de versiones que Parquet simple no ofrece, mejorando la confiabilidad y la capacidad de reprocesar o auditar datos.
¿Cómo se controla el acceso a las capas inferiores como Bronce y Plata?
El acceso a Bronce y Plata debe estar estrictamente restringido y justificado mediante roles separados de escritura y permisos por tabla y columna. Lake Formation centraliza ese gobierno, y ningún consumidor normal debe escribir en Plata u Oro; el acceso a capas inferiores solo procede en casos excepcionales como diagnóstico o exploración técnica.
¿Cuál es el papel del versionado y los manifiestos para el reprocesado y la auditoría?
El versionado en Bronce y la generación de manifiestos por ejecución son fundamentales para permitir reprocesos y auditoría completa. El versionado de objetos en S3 protege el dato original frente a sobrescrituras y cada ejecución debe producir un manifiesto con entradas, salidas, versión de código e identidad para trazar qué ocurrió con cada registro.