
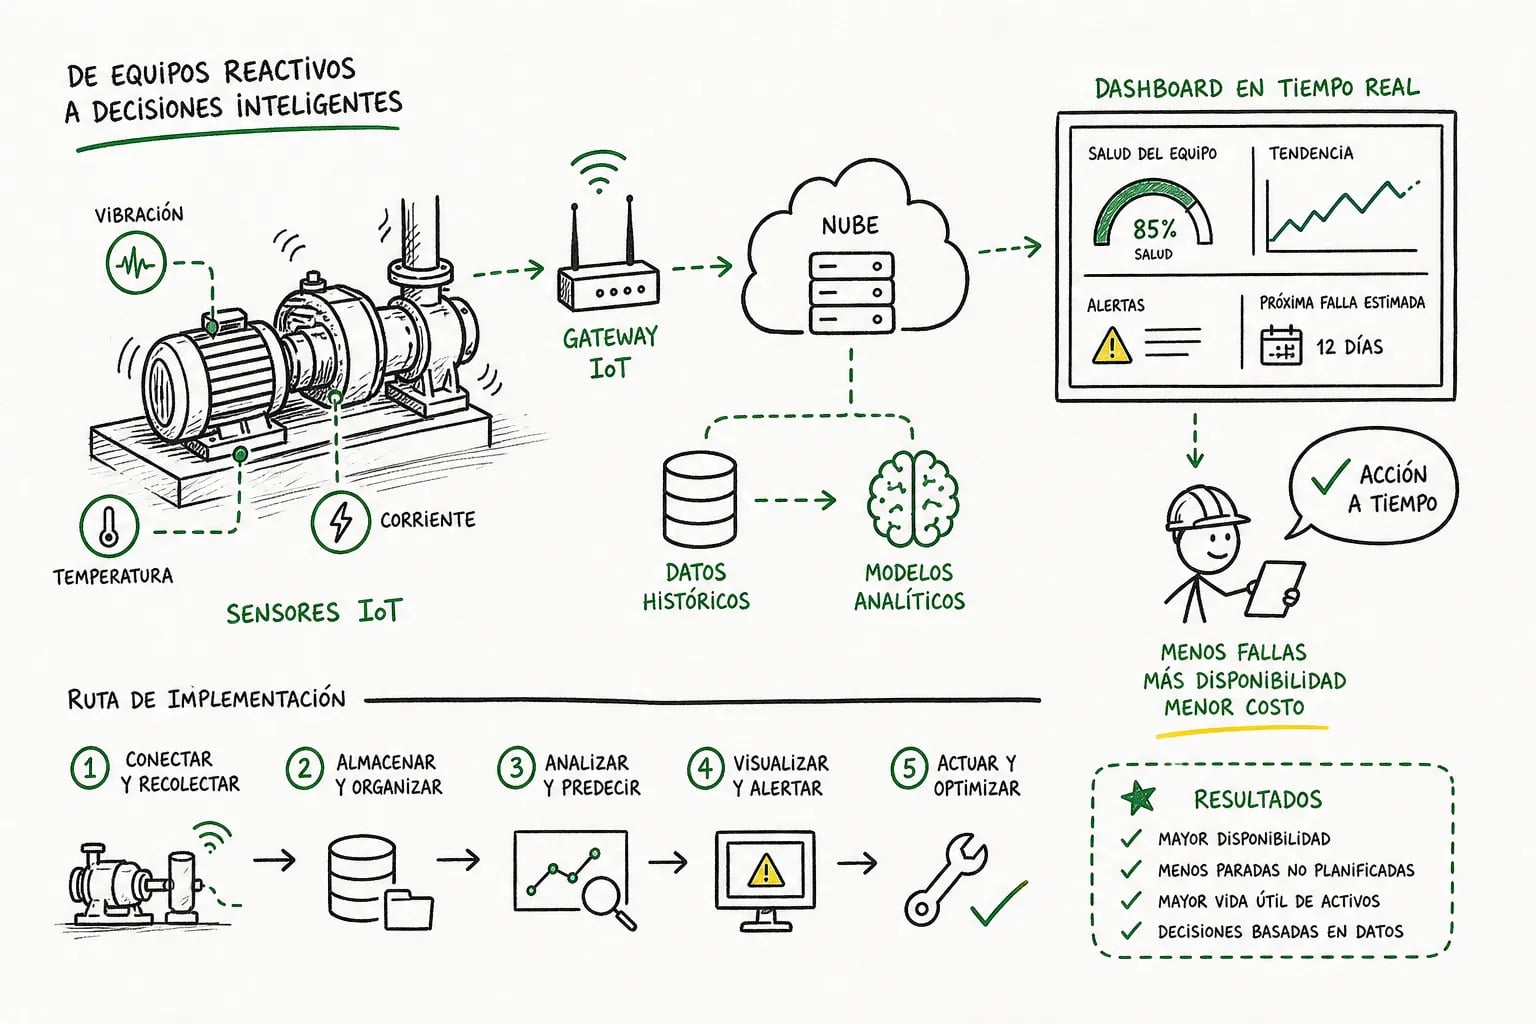
Implementar mantenimiento predictivo en una planta industrial colombiana usando datos e IoT sigue cuatro pasos concretos: seleccionar los activos más críticos, instalar sensores en los puntos correctos, definir la arquitectura de datos y arrancar un piloto medible antes de escalar. No requiere transformar toda la operación de una sola vez. En EPAD Group SAS acompañamos proyectos industriales integrando sensores IoT, modelos analíticos en Python y tableros en Power BI con el objetivo de anticipar fallas y reducir costos de mantenimiento en plantas colombianas.
La mayoría de proyectos no fracasan por el algoritmo elegido: fracasan porque empezaron con el activo equivocado o con datos de baja calidad. Ese error se repite en plantas de manufactura, logística y distribución, y es evitable si se sigue una secuencia clara desde el inicio. Cada sección de este artículo aborda una etapa de esa secuencia.
Lo esencial antes de implementar mantenimiento predictivo con IoT
- Prioridad sobre cobertura: seleccione activos por impacto en producción y costo de parada, no por cercanía o facilidad de instalación.
- Presupuesto de sensores: el costo varía según el tipo de equipo, el número de puntos de medición y los accesorios requeridos; solicite cotizaciones a proveedores especializados antes de proyectar cifras.
- Arquitectura híbrida: el procesamiento en el borde (edge) maneja alarmas localmente; la nube centraliza la analítica. Es la opción más equilibrada para plantas con conectividad variable.
- Detección de anomalías primero: no requiere fallas etiquetadas, ideal para plantas sin historial suficiente de averías.
- Piloto acotado: 5 a 10 activos, un modelo inicial y un tablero en Power BI son suficientes para construir el caso de negocio y decidir si escalar. Un horizonte de 90 días es una práctica habitual en proyectos de este tipo.
¿Qué activos y sensores necesita para arrancar?
Cómo priorizar equipos según criticidad
La selección combina cuatro criterios: impacto en producción si el equipo falla, costo estimado de una parada, frecuencia histórica de fallas y tiempo de consecución de repuestos. Con base en eso, los activos se agrupan en tres categorías: críticos, que requieren monitoreo fijo continuo; de criticidad media, donde son suficientes rutas periódicas; y de baja criticidad, donde basta la inspección visual. En plantas manufactureras colombianas, motores eléctricos, compresores y bombas centrífugas son el punto de partida habitual.
Tipos de sensores y rangos de inversión orientativos
La combinación más efectiva para equipos rotativos es vibración más temperatura. Para motores y tableros eléctricos se agrega corriente; para sistemas hidráulicos, presión; para lubricación y fugas, ultrasonido. Los puntos de medición más importantes son los alojamientos de rodamientos, la carcasa del motor y los terminales eléctricos. El costo del sensor es solo una parte del presupuesto: instalación, concentrador (gateway) y calibración pueden duplicar la inversión inicial.
| Equipo | Sensores recomendados | Fallas detectables | Rango orientativo por activo (USD) |
|---|---|---|---|
| Motor eléctrico | Vibración triaxial + temperatura + corriente | Desbalance, rodamientos, sobrecalentamiento, desequilibrio de fases | 300–800 |
| Bomba centrífuga | Vibración + presión succión/descarga + temperatura | Cavitación, desgaste de rodamientos, obstrucciones | 250–600 |
| Compresor | Vibración + temperatura + presión + ultrasonido | Fugas, sobretemperatura, desgaste mecánico | 400–1.000 |
| Reductor / caja de engranajes | Vibración + temperatura + ultrasonido | Desgaste de dientes, rodamientos, lubricación insuficiente | 300–800 |
| Tablero eléctrico / CCM | Corriente + temperatura + ultrasonido (complemento) | Conexiones flojas, puntos calientes, arco eléctrico | 400–1.200 |
Conectividad: cómo elegir entre 4G, NB-IoT y LoRaWAN
La regla es sencilla: sensores fijos de bajo consumo con pocos bytes de datos apuntan a NB-IoT, siempre que el operador confirme cobertura en el sitio específico. Para concentradores industriales y acceso remoto a SCADA, 4G con APN privado es la opción más madura en Colombia; los rangos de precio varían según operador y plan, por lo que conviene comparar directamente con Claro, Movistar, Tigo y WOM, que operan en el país. Cuando hay cientos de sensores dentro de una sola planta, LoRaWAN privada compite bien. La disponibilidad de NB-IoT y LTE-M debe validarse en sitio antes de contratar cualquier tecnología.
Cómo implementar mantenimiento predictivo en plantas colombianas: arquitectura de datos e integración
La arquitectura más equilibrada combina procesamiento en el borde con sincronización a la nube. El concentrador local normaliza señales, calcula indicadores clave, detecta anomalías y almacena datos durante interrupciones de conectividad. La nube centraliza históricos, modelos y analítica corporativa. Alarmas, enclavamientos analíticos y conteos de producción deben correr localmente: no pueden depender de una conexión a Internet para funcionar.
Los protocolos industriales clave son OPC UA como interfaz principal, Modbus TCP/RTU para equipos heredados y MQTT para telemetría distribuida. La integración con el CMMS debe incluir el maestro de activos, mediciones de condición, alarmas y apertura automática de órdenes de trabajo por umbral o anomalía. Con el ERP, el intercambio cubre órdenes de producción, consumo de materiales y costos de mantenimiento. El patrón recomendado usa interfaces REST para transacciones en tiempo real y webhooks para alarmas. No es recomendable que el CMMS o el ERP accedan directamente a la red OT: en la gran mayoría de arquitecturas se requiere una zona desmilitarizada (DMZ) industrial entre ambas redes para proteger la operación, salvo en configuraciones excepcionalmente justificadas y auditadas.
¿Qué modelos analíticos usar y cuántos datos necesita realmente?
La mayoría de plantas colombianas no tienen suficientes fallas etiquetadas para arrancar con aprendizaje supervisado. Por eso, el punto de partida correcto es la detección de anomalías: modelos como Isolation Forest, One-Class SVM o autoencoders aprenden el comportamiento normal del equipo y alertan cuando algo se desvía. No necesitan ejemplos de averías previas para funcionar. El requisito mínimo es varios meses de operación normal que cubran los principales regímenes de carga, velocidad y temperatura. Lo que importa no es el volumen de lecturas, sino que sean representativas de los modos operativos reales.
Cuando ya existen decenas de fallas confirmadas por tipo, entran los modelos supervisados: Random Forest y XGBoost como punto de partida, LSTM y GRU cuando las dependencias temporales de vibración o corriente son relevantes. Para flotas de activos donde algunos aún no han fallado, los modelos de supervivencia como Weibull o Random Survival Forest producen probabilidades de falla en el tiempo, no solo alertas binarias. Una advertencia clave: un millón de lecturas durante una sola avería no equivale a un millón de fallas. La unidad correcta de medición es el número de eventos independientes, no el número de registros en la base de datos.
Cómo diseñar un piloto en 90 días y medir el retorno
Estructura del piloto mínimo viable semana a semana
El piloto se divide en tres bloques claros. Durante las primeras cuatro semanas: seleccionar 5 a 10 activos críticos, instalar sensores, validar la conectividad y comenzar la recolección de datos en condiciones normales. De la semana cinco a la diez: construir la arquitectura básica de datos, integrar con el CMMS, desarrollar el primer modelo de detección de anomalías y crear el tablero operativo en Power BI. En las semanas once y doce: medir resultados contra la línea base, ajustar umbrales, documentar fallas detectadas con anticipación y presentar el caso de negocio para escalar.
KPIs para justificar la inversión y escalar
Los indicadores clave son disponibilidad de equipos (OEE), tiempo medio entre fallas (MTBF), tiempo medio de reparación (MTTR), costo de mantenimiento correctivo frente a predictivo y número de paradas no programadas evitadas. La línea base se construye con 6 a 12 meses de datos históricos del CMMS; si no existen, los primeros 60 días del piloto en modo observación sirven de referencia. Proyectos documentados de mantenimiento predictivo maduro reportan reducciones significativas en costos de mantenimiento y en tiempos de parada no programada. Estas cifras son referencias orientadoras, no garantías: cada planta parte de condiciones distintas.
Cómo EPAD Group SAS acompaña este proceso en plantas colombianas
En EPAD Group SAS integramos la cadena completa: selección e instalación de sensores IoT, arquitectura de datos en nube híbrida con Azure, AWS y Databricks, modelos analíticos en Python y tableros operativos en Power BI. El enfoque es práctico: definimos junto con la planta los activos prioritarios, diseñamos la arquitectura de datos adaptada a la conectividad disponible y construimos los primeros modelos de detección de anomalías con los datos recolectados en el piloto. Al cerrar el piloto, el resultado esperado es un tablero en Power BI con alertas anticipadas de falla, indicadores de mantenimiento actualizados en tiempo real y un modelo validado listo para escalar a otros activos o sedes. Si quiere saber por dónde empezar, contáctenos para agendar una sesión de diagnóstico en la que revisamos juntos sus activos prioritarios y la conectividad disponible.
Preguntas frecuentes sobre cómo implementar mantenimiento predictivo en una planta industrial colombiana con IoT
¿Cuánto cuesta implementar mantenimiento predictivo en una planta colombiana?
El costo varía según el número de activos, la conectividad disponible, el nivel de integración con CMMS y ERP, y si se requiere construir infraestructura desde cero. Como referencia orientadora de mercado, un piloto básico para alrededor de 10 activos críticos, incluyendo sensores, conectividad, arquitectura de datos y modelos iniciales, puede representar una inversión considerablemente menor que una implementación de alcance completo. Solicite una valoración adaptada a su planta antes de proyectar cifras.
¿Cuántos datos necesito antes de construir el primer modelo predictivo?
Para detección de anomalías, varios meses de operación normal en los regímenes habituales de carga son suficientes para empezar. Para modelos supervisados, se necesitan al menos decenas de fallas confirmadas y etiquetadas por tipo de falla. El volumen de lecturas importa menos que la calidad de las etiquetas y la representatividad de los modos operativos.
¿Qué pasa si mi planta no tiene conectividad estable?
La arquitectura híbrida con procesamiento en el borde resuelve este problema. El concentrador local almacena datos durante las interrupciones y los sincroniza cuando se restablece la conexión. Las alarmas críticas siguen funcionando localmente sin depender de Internet, lo que protege la continuidad operativa.
¿El mantenimiento predictivo reemplaza el mantenimiento preventivo?
No los reemplaza: los complementa. La estrategia recomendada combina mantenimiento preventivo por uso, medido en horas o ciclos, en activos de criticidad media, con mantenimiento predictivo basado en condición en los activos críticos donde el costo de una parada no programada es mayor.
¿Qué tecnologías de nube recomienda para proyectos industriales en Colombia?
Microsoft Azure con Azure IoT Hub, Databricks o Microsoft Fabric para ingeniería de datos, y Power BI para visualización son la combinación más común en proyectos industriales colombianos. AWS ofrece alternativas equivalentes según el ecosistema tecnológico existente en cada empresa. La elección final depende más de la integración con los sistemas actuales que de las capacidades técnicas de cada plataforma.