
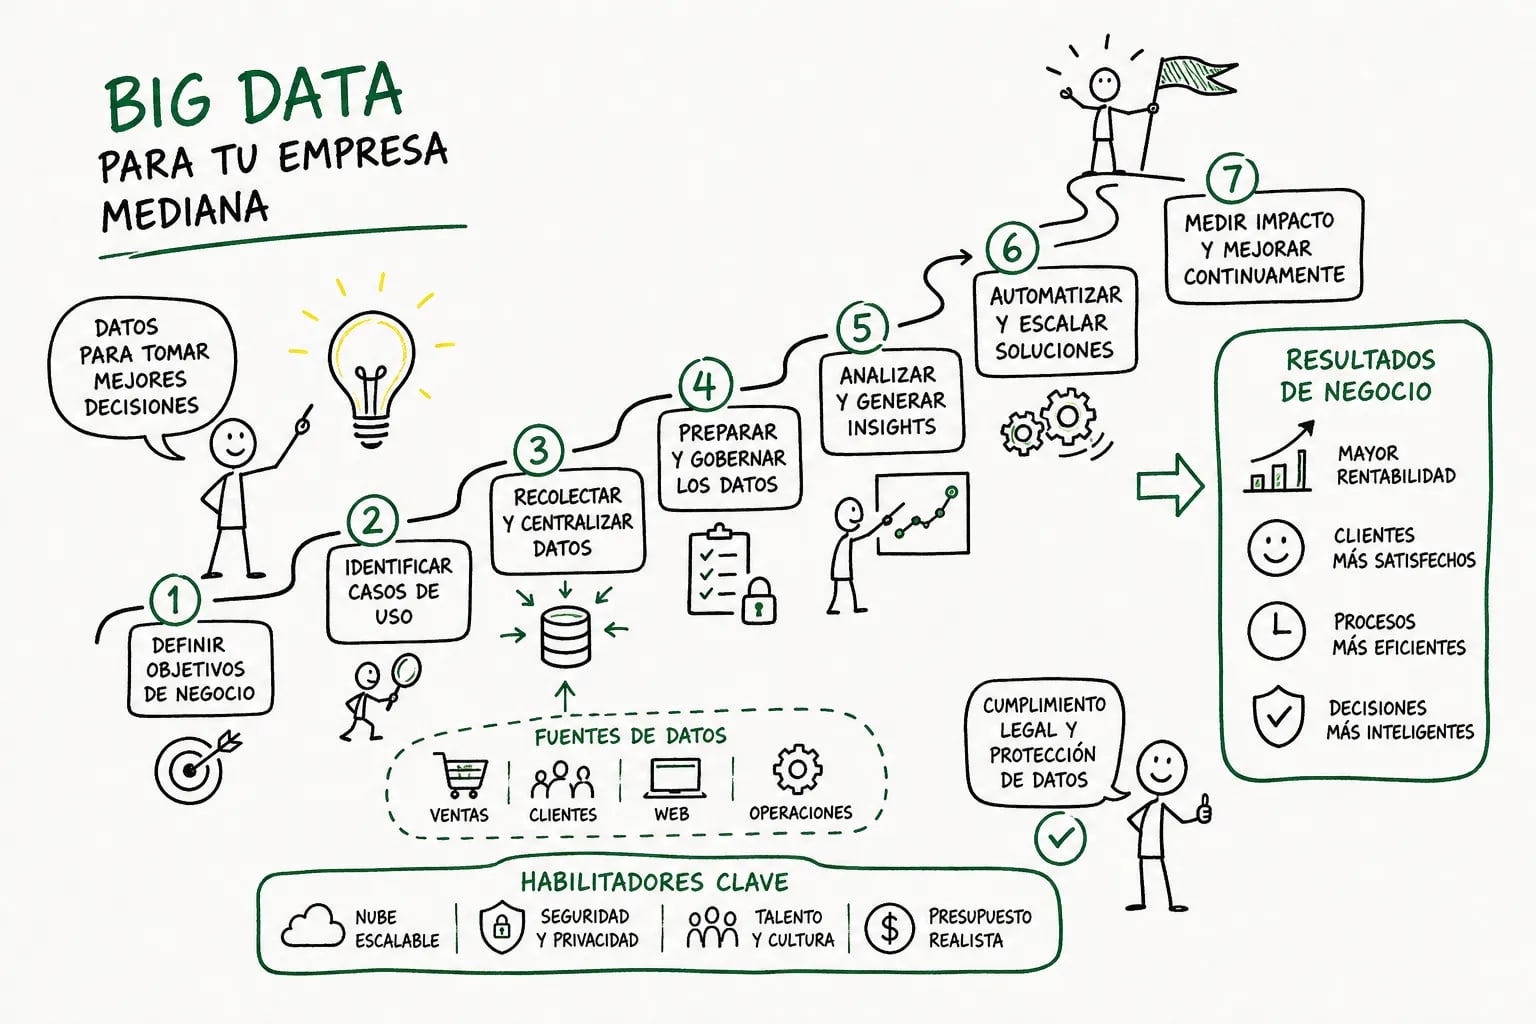
Si te preguntas cómo puede una empresa mediana en Colombia empezar a usar Big Data, la respuesta más honesta es esta: no necesitas cincuenta ingenieros ni un presupuesto de multinacional. Empresas medianas en todo el país ya extraen valor real de sus datos con inversiones iniciales razonables, y los resultados son concretos: menor fuga de clientes, rutas de despacho más eficientes, inventarios más precisos.
El contexto cambió de forma radical en los últimos años. La nube eliminó la necesidad de servidores propios, las herramientas de código abierto redujeron el costo de entrada de manera significativa y surgieron socios especializados con experiencia local. En EPAD Group SAS acompañamos proyectos de datos con empresas colombianas de distintos sectores, y el patrón que más se repite es siempre el mismo: las organizaciones que empiezan por un caso de uso concreto obtienen retorno mucho más rápido que las que intentan construir una plataforma completa desde el inicio. Al terminar este artículo, tendrás un caso de uso identificado, un plan de 7 pasos y mayor claridad sobre herramientas, presupuesto y marco legal.
Cómo puede una empresa mediana en Colombia empezar a usar Big Data sin arruinarse
El modelo antiguo exigía infraestructura propia, licencias costosas y equipos grandes. El modelo actual funciona sobre pago por uso: una empresa mediana puede montar su primera arquitectura de datos con servicios gestionados en Azure, AWS o Google Cloud, y pagar solo por lo que consume. Herramientas de código abierto como Airbyte, PostgreSQL y Metabase hacen posible comenzar con una inversión inicial entre COP 20 y COP 80 millones para un proyecto de arranque bien contenido.
El error más frecuente es querer construir todo antes de demostrar valor. Una empresa que diseña un lago de datos completo antes de generar un solo tablero útil suele gastar en el primer año más de lo que logra recuperar. El primer proyecto debe ser pequeño, enfocado y medible. Si no genera ahorros o ingresos adicionales que justifiquen la inversión en ese período, probablemente estuvo mal definido desde el inicio.
El verdadero punto de partida: elegir un caso de uso con impacto medible
Los cinco casos más probados en empresas medianas colombianas son ventas, logística, retención, precios y mantenimiento predictivo. En ventas, la analítica identifica los clientes con mayor probabilidad de compra. En logística, los modelos predictivos optimizan rutas e inventario; como referencia, Rappi ha reportado en entrevistas públicas mejoras significativas en tiempos de entrega gracias a la analítica aplicada a su operación. En retención, el modelo detecta señales de fuga antes de que el cliente se vaya y activa acciones correctivas en el momento oportuno.
Para elegir el caso correcto, verifica que los datos ya existan dentro de la empresa, que el impacto económico sea directo y cuantificable, y que sea posible medir resultados en un plazo razonable, preferiblemente en menos de seis meses, aunque el periodo puede variar según la madurez de los datos y la complejidad del caso, . Empieza por el caso donde tengas más datos propios y mayor dolor operativo, no por el que suena más atractivo desde el punto de vista tecnológico. Cuando ese primer caso ya entregue valor, es el momento natural para explorar la ciencia de datos para empresas medianas: pasar de analítica descriptiva a modelos predictivos más sofisticados.
Las herramientas que necesitas (y las que todavía no)
La arquitectura mínima viable se compone de tres capas. Airbyte se encarga de la ingesta: conecta múltiples fuentes con poco código y tiene una curva de aprendizaje moderada para equipos pequeños. En almacenamiento, PostgreSQL funciona bien con volúmenes moderados; si tus datos tienen componente temporal, métricas de sensores o registros de operación, por ejemplo, la extensión natural es TimescaleDB, que está diseñada específicamente para ese tipo de series. La visualización, por su parte, puede cubrirse con Metabase para tableros de autoservicio rápidos, o con Power BI si ya tienes ecosistema Microsoft consolidado.
Apache Spark y las soluciones de procesamiento distribuido entran en escena solo cuando el volumen crece de forma significativa. Para empezar, la pila básica de tres componentes es suficiente. En cuanto a la nube, la selección depende de tu perfil: Azure si ya usas Microsoft 365, AWS si necesitas máxima flexibilidad técnica, y Google Cloud si el foco es analítica SQL sobre grandes volúmenes con BigQuery. Los proveedores locales gestionados son una alternativa válida para empresas sin equipo técnico robusto, porque reducen la carga operativa desde el inicio.
Equipo, presupuesto y obligaciones legales que debes conocer
El modelo más funcional para una empresa mediana es el híbrido: externalizar la arquitectura inicial y los primeros flujos de datos, y contratar internamente al menos un responsable de datos, un ingeniero de datos y un analista. La consultora aporta velocidad; el equipo interno se queda con el conocimiento y la capacidad de operar a largo plazo.
En términos de costos, un proyecto de arranque bien definido cuesta entre COP 20 y COP 80 millones. La operación mensual, para un alcance básico a medio, se ubica entre COP 1 y COP 8 millones, incluyendo infraestructura en la nube y soporte técnico. La Ley 1581 de 2012 no es opcional. Si tu proyecto procesa datos personales, debes cumplir con varias obligaciones clave: obtener autorización previa del titular e informar la finalidad del tratamiento son los primeros pasos; mantener la seguridad de la información y registrar las bases de datos ante la Superintendencia de Industria y Comercio completan el marco mínimo. La gobernanza no solo protege a la empresa de sanciones: también mejora la calidad del análisis.
Los 7 pasos para arrancar tu proyecto de Big Data hoy
1. Identifica el caso de uso
Usa los criterios descritos: datos ya disponibles en la empresa, impacto económico directo y resultados verificables en un plazo razonable. Si dudas entre dos opciones, elige la que tenga datos más limpios, no la que parezca más ambiciosa.
2. Audita los datos existentes
Mapea las fuentes disponibles con un inventario sencillo, una hoja de cálculo basta al principio, evalúa la calidad de la información y define los niveles de acceso actuales. Este paso revela rápidamente qué tan lejos o cerca estás de poder empezar.
3. Define el equipo y el modelo de contratación
Decide qué roles contratas internamente y qué externalizas. El modelo híbrido es el punto de partida más sólido para la mayoría de las empresas medianas: combina velocidad de ejecución con transferencia real de conocimiento.
4. Elige la infraestructura y las herramientas
Selecciona la nube según tu perfil tecnológico actual y monta la pila básica de ingesta, almacenamiento y visualización. Agrega complejidad solo cuando el caso base ya esté funcionando y entregando valor.
5. Construye los primeros flujos y el tablero inicial
El objetivo es tener datos llegando al destino y un tablero con las métricas del caso de uso elegido. No busques perfección; busca funcionalidad. Un tablero imperfecto que se usa todos los días vale más que uno perfecto que nadie consulta.
6. Verifica el cumplimiento de la Ley 1581
Formaliza la política de tratamiento de datos, define el responsable del dato y asegúrate de que las autorizaciones estén documentadas antes de escalar. Hacer esto al inicio evita reprocesos costosos más adelante.
7. Mide resultados y planea la siguiente iteración
Evalúa los resultados frente al impacto esperado en los primeros 90 días, o en el plazo que definiste al inicio, e identifica los ajustes necesarios. En nuestra experiencia con proyectos de datos en Colombia, el segundo ciclo suele ser más rápido y más preciso que el primero: el equipo ya conoce los datos, los procesos y los puntos de fricción más comunes. Define el siguiente caso de uso y vuelve al paso 1.
Recorrer este camino con acompañamiento hace una diferencia real. En EPAD Group SAS trabajamos como socio estratégico en proyectos de procesamiento y análisis de datos para empresas colombianas, con experiencia directa en el contexto local. Si quieres saber cómo puede tu empresa empezar a usar Big Data de forma práctica y sin desperdiciar presupuesto, acércate a nuestro equipo y conversamos.