
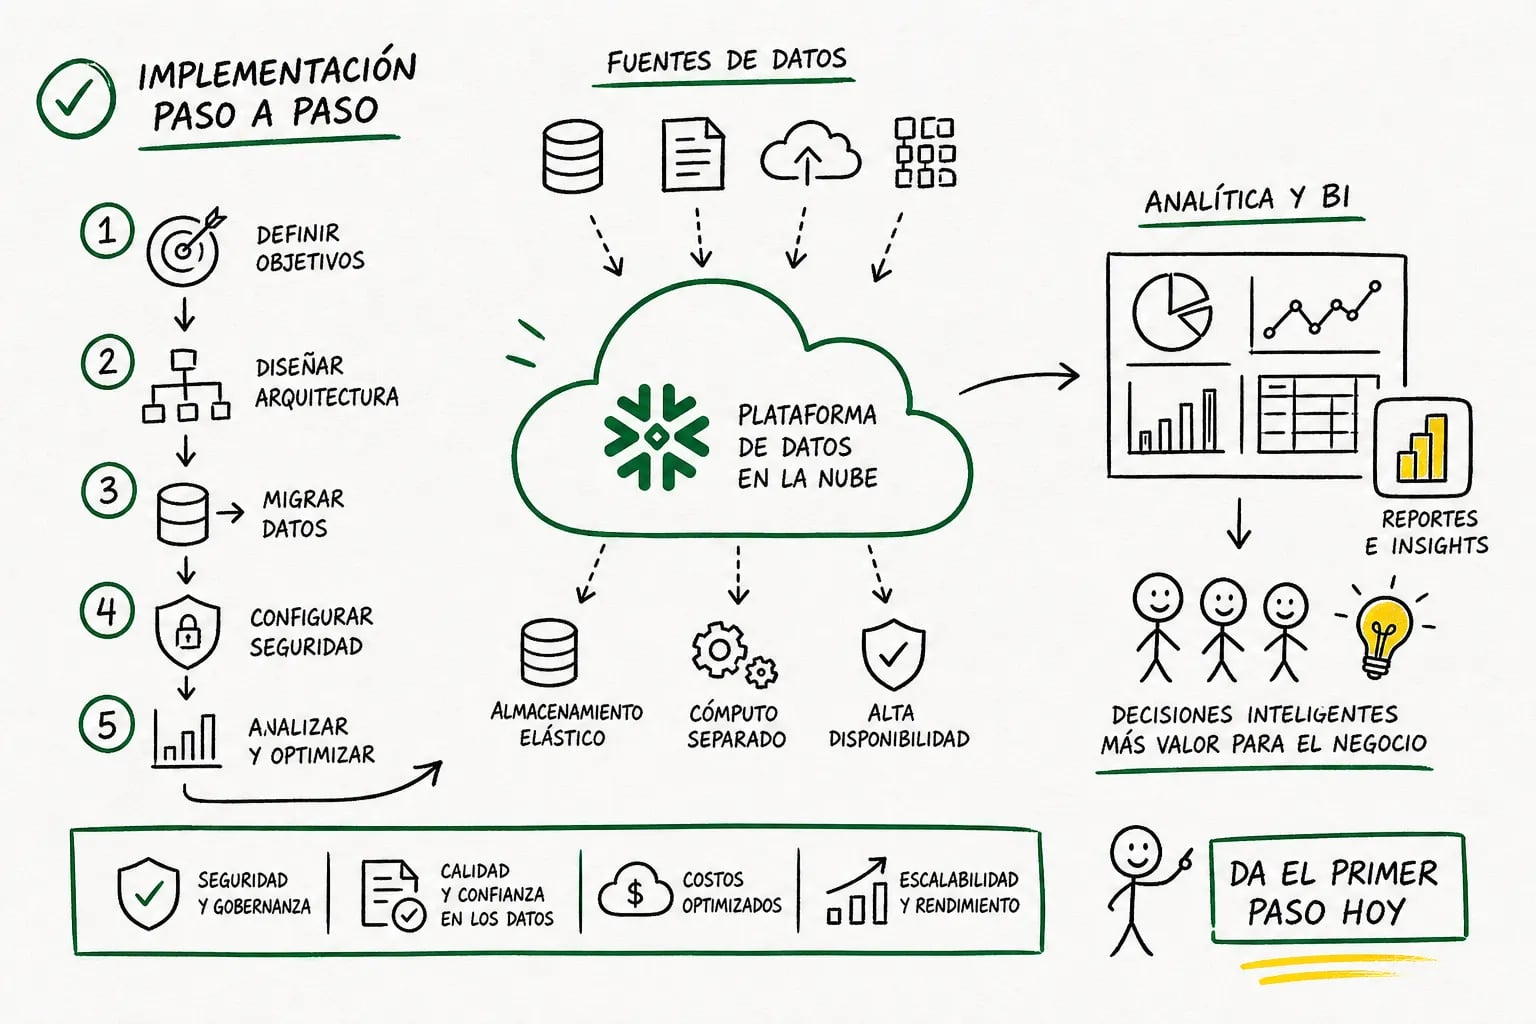
Para implementar Snowflake en tu empresa, el primer paso es comprender que el éxito del proyecto depende del plan, no de la plataforma. Snowflake se ha consolidado como una de las plataformas más adoptadas para construir un almacén de datos en la nube, y empresas de todos los tamaños migran hacia ella por su capacidad de escalar, su rendimiento y la separación entre cómputo y almacenamiento. Sin embargo, uno de los factores principales de fracaso en estos proyectos es la ausencia de un plan claro, no las limitaciones de la herramienta.
En EPAD Group SAS hemos acompañado proyectos de adopción de Snowflake en organizaciones colombianas con arquitecturas, industrias y niveles de madurez de datos muy distintos. Esa experiencia nos permite trazar el camino que funciona. Al terminar este artículo, tendrás un plan concreto para arrancar tu proyecto.
Cómo implementar Snowflake en tu empresa: diseño de arquitectura
El diseño de la arquitectura es la decisión más crítica de todo el proyecto. Tomar esta decisión antes de escribir una sola línea de código evita semanas de deuda técnica. Snowflake desacopla cómputo y almacenamiento, lo que cambia radicalmente el diseño respecto a un almacén tradicional: no hay índices que mantener ni particiones que calcular manualmente.
El modelo de capas recomendado contempla cuatro niveles: RAW, Preparación (Staging), Integración Central (Core) y Presentación (Mart). Cada capa tiene una responsabilidad única y no comparte lógica con las demás. La capa RAW conserva los datos originales sin modificación. La capa de preparación estandariza y valida. La capa de integración central consolida el modelo empresarial, y la capa de presentación expone hechos y dimensiones para consumo en herramientas de visualización. Saltarse estas capas genera deuda técnica desde el primer día.
Separación de entornos y almacenes virtuales
Crea almacenes virtuales independientes para cada tipo de carga: uno para ingesta, otro para transformación, otro para inteligencia de negocios y otro para ciencia de datos. Mezclar cargas en un mismo almacén virtual provoca competencia de recursos y costos impredecibles. Separar los entornos de desarrollo, pruebas y producción es igualmente obligatorio desde el inicio, no una optimización posterior.
Configura roles, seguridad y entornos desde cero
La seguridad no es una etapa final: es una condición de partida. En Snowflake el control de acceso se basa en RBAC. El modelo correcto separa roles funcionales (analista, ingeniero, administrador) de roles de acceso a objetos concretos. Conceder permisos directamente a usuarios es uno de los errores más frecuentes y de los más difíciles de corregir después.
Exige autenticación multifactor para todos los usuarios humanos y autenticación por par de claves u OAuth para las cuentas de servicio. Usa permisos futuros (future grants) para que los nuevos objetos hereden permisos coherentes de forma automática. Revisa periódicamente los privilegios heredados y los accesos temporales. Un acceso que nadie revoca termina siendo una puerta abierta.
El enmascaramiento dinámico de datos (Dynamic Data Masking) permite mostrar o enmascarar columnas según el rol que consulta, sin necesidad de duplicar tablas. Las políticas de acceso por filas (Row Access Policies) restringen registros por territorio, cliente o unidad organizativa. Usa etiquetas para clasificar columnas con datos personales, financieros o de salud y asociarles políticas automáticamente, incluyendo los objetos que se creen en el futuro.
Migración para implementar Snowflake en tu empresa: carga y validación
La migración tiene dos momentos distintos: la carga histórica inicial y la ingesta continua. El error más común es asumir que si las tablas cargan sin errores, la migración fue exitosa. La validación formal con reconciliación de conteos, totales financieros y muestras de datos es la garantía real de integridad; sin ella, los problemas aparecen en producción.
Carga histórica e ingesta continua
Para la carga histórica, extrae los datos del sistema origen y escríbelos en archivos comprimidos en almacenamiento en la nube (S3, Azure Blob o GCS). Divídelos en archivos de 100 a 250 MB para aprovechar la carga paralela, según las guías de buenas prácticas de paralelización, aunque el tamaño óptimo puede variar según la nube y el origen. Luego carga con COPY INTO y opera ambas plataformas en paralelo hasta que las métricas críticas coincidan. Solo entonces realiza el corte definitivo.
Para la ingesta continua, Snowpipe maneja archivos incrementales y la captura de cambios en datos (CDC) replica modificaciones desde bases operacionales. Las herramientas más utilizadas en el mercado son Fivetran para rapidez y bajo mantenimiento, Airbyte para mayor flexibilidad, y Azure Data Factory cuando el ecosistema es Microsoft. La arquitectura estándar moderna combina ingesta gestionada con transformación ELT dentro de Snowflake.
Conecta Snowflake con Power BI y automatiza las transformaciones
La conexión con Power BI es el momento en que el valor del proyecto se hace visible para el negocio. Snowflake tiene un conector nativo que evita la necesidad de controladores genéricos. La elección entre consulta directa (DirectQuery) e importación tiene consecuencias directas sobre el rendimiento y el costo.
La consulta directa accede a Snowflake en tiempo real, lo que resulta útil cuando los datos cambian con frecuencia o el volumen es demasiado grande para importar. La importación carga los datos al motor en memoria de Power BI y ofrece mayor velocidad para paneles con datos estables. En la mayoría de los casos corporativos, la importación debe ser la opción inicial; la consulta directa se reserva cuando la actualidad del dato es un requisito de negocio explícito.
Orquestación y flujos de transformación
dbt es la herramienta estándar para transformar datos dentro de Snowflake mediante SQL versionado, con modelos, pruebas y linaje documentado. Apache Airflow o Dagster orquestan las dependencias entre flujos de datos. La arquitectura recomendada conecta Fivetran o Azure Data Factory hacia Snowflake, aplica dbt para transformación y entrega los resultados a Power BI o Tableau para visualización.
Costos reales, errores frecuentes y cuándo apoyarte en un equipo experto
Snowflake no cobra una licencia plana: factura por consumo de créditos de cómputo y almacenamiento comprimido. Para una empresa mediana con 25 a 50 TB comprimidos, cargas ETL diarias y uso de inteligencia de negocios en horario laboral, el costo mensual suele situarse entre US$6.000 y US$18.000, según la región, la edición de Snowflake y los acuerdos de capacidad comprometida. El almacenamiento ronda US$23 por TB al mes en condiciones estándar; el cómputo depende del tamaño y tiempo de actividad de cada almacén virtual.
Las palancas de ahorro más efectivas son operativas e inmediatas: configura la suspensión automática (auto-suspend) en todos los almacenes virtuales, usa tamaños pequeños y escala solo cuando sea necesario, y separa las cargas de trabajo para evitar sobredimensionar. Para el mediano plazo, evalúa capacidad comprometida una vez que el consumo sea estable. Un presupuesto inicial razonable es US$10.000 al mes; ajústalo después de observar cuatro a ocho semanas de consumo real.
Los errores que con mayor frecuencia comprometen estos proyectos son: omitir el diseño de capas, mezclar cargas de trabajo en el mismo almacén virtual, migrar todo en un solo momento sin validación paralela, no configurar límites de créditos desde el día uno y dejar la seguridad para el final. Ninguno de estos errores es técnicamente difícil de evitar; todos requieren disciplina de proceso.
El primer paso importa más que el destino final
Implementar Snowflake en tu empresa no es un proceso de días, pero tampoco tiene que ser caótico. Con la arquitectura definida, la seguridad configurada desde el inicio y una migración formalmente validada, el tiempo estimado para tener un primer entorno productivo va de 8 a 12 semanas, de acuerdo con referencias de implementación en proyectos similares. Empezar con un dominio piloto de alto valor reduce el riesgo y entrega resultados concretos antes de escalar.
En EPAD Group SAS acompañamos la implementación de Snowflake adaptada a la arquitectura, las fuentes de datos y los procesos específicos de cada organización, desde el diseño inicial hasta la operación estable en producción. Eso incluye integración con Power BI y flujos de transformación con dbt. Si quieres evaluar el punto de partida más adecuado para tu empresa, comunícate con nuestro equipo y lo definimos juntos.