
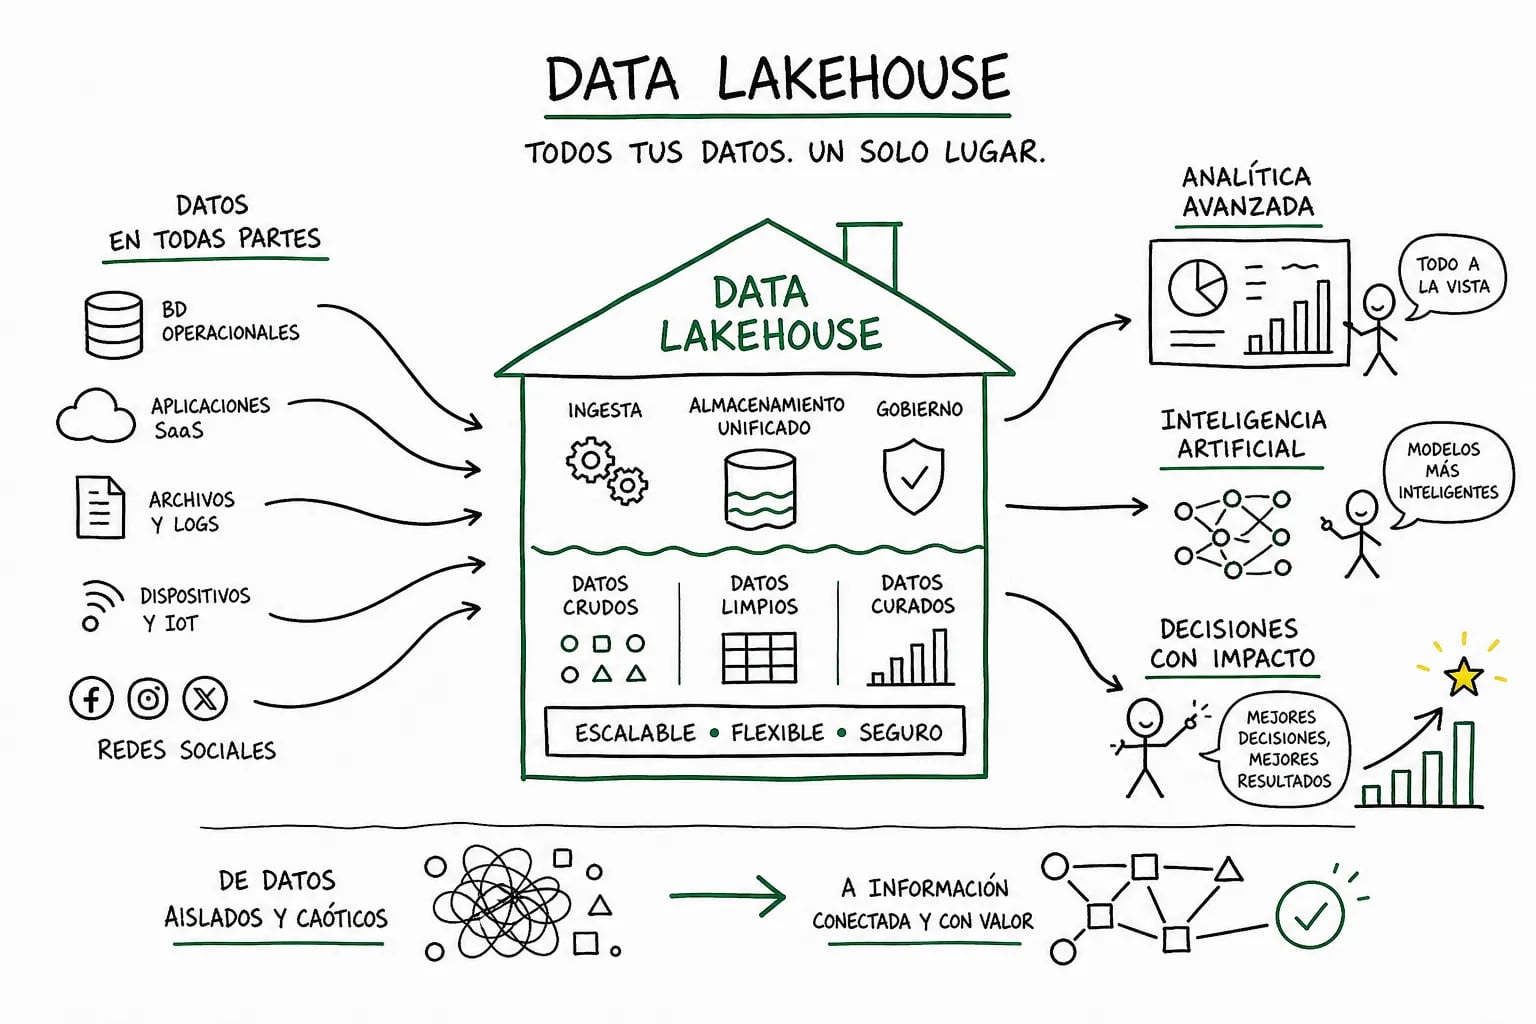
Un data lakehouse (o lakehouse de datos) es una arquitectura que unifica la flexibilidad y el bajo costo de un lago de datos con la gobernanza, el rendimiento y la gestión estructurada de un almacén de datos, todo en una sola plataforma. Muchas organizaciones llegan a esta arquitectura cuando sus datos crecen más rápido que su infraestructura actual y los modelos tradicionales ya no responden.
En EPAD Group implementamos estas arquitecturas para organizaciones en Colombia que necesitan pasar de datos dispersos a información gobernada con analítica de alto rendimiento. Este artículo explica cuándo conviene adoptarla, qué tecnologías la sostienen y cómo empezar.
Puntos clave
- Una sola plataforma: elimina la necesidad de mantener copias separadas en lago y almacén de datos, reduciendo duplicación y procesos de conciliación.
- Gobernanza integrada: las transacciones ACID, el control de esquemas y la seguridad forman parte integral del diseño desde el inicio, no son un añadido posterior.
- Almacenamiento económico: permite usar almacenamiento de objetos de bajo costo y, con la optimización adecuada en particiones y cómputo, mantener rendimiento analítico.
- Compatible con múltiples herramientas: SQL, Python, Spark y Power BI funcionan sobre la misma plataforma.
- Exige madurez técnica: requiere equipos con experiencia en ingeniería de datos, nube y gobernanza.
- No es para todos: si solo necesitas reportes SQL simples con pocos datos, un almacén gestionado puede ser la mejor opción.
¿En qué se diferencia de un lago de datos y de un almacén de datos?
El lago de datos almacena todo en su formato original: flexible y económico, pero sin estructura ni gobierno puede volverse un pantano de datos inútil. El almacén de datos prioriza datos limpios y estructurados para consultas rápidas y consistentes, pero es rígido y costoso para volúmenes grandes o tipos de datos variados.
El data lakehouse resuelve exactamente ese dilema: conserva la flexibilidad del lago y añade las capacidades transaccionales, el control de calidad, la seguridad y las consultas optimizadas propias de un almacén. El resultado es una plataforma donde los mismos datos sirven para informes de negocio, analítica avanzada e inteligencia artificial, sin duplicar infraestructura.
| Aspecto | Lago de datos | Almacén de datos | Lakehouse |
|---|---|---|---|
| Tipos de datos | Estructurados, semiestructurados y no estructurados | Principalmente estructurados | Los tres tipos |
| Esquema | Se define al consultar | Se define antes de cargar | Flexible con controles y estructura |
| Costo y escalabilidad | Muy bajo costo, alta escalabilidad | Mayor costo, más rígido | Bajo costo con rendimiento analítico |
| Usos habituales | Ciencia de datos, exploración masiva | BI, reportes, métricas empresariales | BI, analítica avanzada, IA y ML |
| Gobernanza | Limitada sin herramientas adicionales | Alta y bien definida | Alta, integrada desde el diseño |
¿Qué tecnologías hacen posible un data lakehouse abierto?
Delta Lake, Apache Iceberg y Apache Hudi son los tres formatos de tabla transaccionales que habilitan esta arquitectura. Los tres funcionan sobre almacenamiento de objetos de bajo costo, admiten transacciones ACID, permiten la evolución de esquemas y ofrecen consultas históricas mediante viaje en el tiempo. La diferencia está en sus prioridades de diseño.
| Tecnología | Fortaleza principal | Mejor encaje |
|---|---|---|
| Delta Lake | Integración profunda con Apache Spark y Databricks; operación sencilla para cargas mixtas de procesamiento por lotes y streaming | Plataformas centradas en Databricks o Microsoft Fabric |
| Apache Iceberg | Diseñado para interoperabilidad entre múltiples motores y nubes; independencia de proveedor | Arquitecturas multi-motor con Spark, Flink, Trino u otros |
| Apache Hudi | Especializado en ingestión incremental, captura de cambios y actualizaciones frecuentes con baja latencia | Replicación continua de bases de datos transaccionales y datos casi en tiempo real |
La elección entre los tres depende del patrón de escritura, los motores existentes y el nivel de dependencia del proveedor que tu organización está dispuesta a aceptar. Si tu ecosistema ya opera sobre Databricks o Microsoft Fabric, Delta Lake es la elección natural. Si varios motores necesitan leer los mismos datos sin atarse a un proveedor, Iceberg ofrece mayor neutralidad. Y si el requisito central son actualizaciones frecuentes con baja latencia, Hudi es la opción especializada.
¿Cuándo es el momento adecuado para adoptar un data lakehouse?
Tu arquitectura actual probablemente ya no es suficiente cuando se presentan estas señales:
- Tu equipo mantiene copias separadas en un lago y en un almacén de datos, y reconciliarlas consume tiempo y genera inconsistencias.
- Necesitas combinar BI, analítica avanzada, streaming e inteligencia artificial sobre los mismos datos.
- Los volúmenes y la variedad de tus fuentes superan la capacidad de un almacén tradicional a un costo razonable.
Sin embargo, el lakehouse de datos no es la respuesta correcta para todo. Si tu organización solo necesita reportes SQL relativamente simples con pocos datos y requisitos estrictos de baja latencia, un almacén gestionado ofrece menor complejidad operativa. El lakehouse exige madurez técnica: equipos con experiencia en ingeniería de datos, nube y gobernanza. Sin eso, la complejidad supera los beneficios.
Cómo EPAD Group diseña e implementa arquitecturas lakehouse de datos
En EPAD Group diseñamos e implementamos arquitecturas lakehouse sobre Microsoft Fabric, Databricks y Azure, adaptadas a las necesidades específicas de cada cliente. El enfoque parte de los casos de uso prioritarios de cada organización: BI, analítica avanzada, IA y ML, o integración de fuentes diversas. No existe una plantilla única.
La gobernanza, la seguridad y la calidad de datos forman parte integral del diseño desde el inicio, no como un añadido posterior. Ofrecemos soporte y acompañamiento tecnológico para la implementación, operación y optimización de las soluciones.
Preguntas frecuentes sobre el lakehouse de datos
¿Un lakehouse reemplaza mi almacén de datos actual?
No necesariamente. En muchos casos coexisten durante la transición, o el lakehouse asume gradualmente las cargas que antes manejaba el almacén. El ritmo de migración depende de la madurez del equipo y de los casos de uso prioritarios.
¿Qué tan costoso es implementarlo?
El almacenamiento de objetos suele ser significativamente más económico que el de un almacén tradicional, pero el costo total depende del cómputo, la transferencia de datos y la complejidad operativa del proyecto.
¿Necesito un equipo grande de datos?
Un equipo pequeño pero especializado en ingeniería de datos y nube es suficiente para comenzar con un caso de uso bien delimitado. A medida que crecen los volúmenes y los casos de uso, el equipo puede escalar gradualmente.
¿Microsoft Fabric incluye capacidades de lakehouse?
Sí. OneLake de Microsoft Fabric usa Delta Lake como formato base y permite trabajar con datos estructurados, semiestructurados y no estructurados en una plataforma unificada.
El lakehouse de datos no es el destino: es la plataforma
El valor real no viene de adoptar la arquitectura en sí, sino de unificar almacenamiento, procesamiento, gobierno y consumo analítico sobre una base común y gobernada. Si tu empresa necesita combinar BI, inteligencia artificial y analítica avanzada sobre los mismos datos sin duplicar infraestructura, el data lakehouse es el camino con más sentido técnico y económico.
Si no estás seguro de si tu arquitectura actual está lista para ese paso, o quieres saber qué tan lejos estás de estarlo, conversa con nuestro equipo en EPAD Group. Evaluamos tu situación actual y te decimos con claridad qué tiene sentido para tu organización y qué no.
Preguntas frecuentes
¿Cuánto tiempo suele tomar la migración a un lakehouse?
Depende de la madurez del equipo y de los casos de uso prioritarios; la migración puede ser gradual. En muchos casos el lakehouse y el almacén coexisten durante la transición y las cargas se van trasladando a ritmo acorde con la experiencia del equipo y las prioridades de negocio.
¿Qué errores comunes debemos evitar al intentar implementar un lakehouse?
Eviten lanzarse sin madurez técnica y sin gobernanza integral, porque la complejidad puede superar los beneficios. También eviten mantener copias separadas sin un plan de conciliación, ya que eso consume tiempo y genera inconsistencias.
¿Cómo se gestionan la seguridad y la gobernanza en un lakehouse?
La gobernanza y la seguridad deben ser parte integral del diseño desde el inicio, no añadidos posteriores. Eso incluye transacciones ACID, control de esquemas y medidas de calidad de datos para garantizar consumo analítico consistente y seguro.
Si elegimos Delta Lake, quedamos atados a un proveedor?
Elegir Delta Lake suele encajar naturalmente con ecosistemas centrados en Databricks o Microsoft Fabric, por lo que implica mayor cercanía a esos proveedores. Si la neutralidad entre motores y nubes es prioritaria, Apache Iceberg ofrece mayor independencia; la elección depende del patrón de escritura y del nivel de dependencia que su organización esté dispuesta a aceptar.